工程研究
Swarms 对比 LangGraph、CrewAI、AutoGen 等八个框架:一次框架开销基准测试
我们把模型替换成桩,在九个智能体框架上运行同样的 100 智能体任务,再把规模扩大到 1,000 个智能体。Swarms 在 48 项对比中领先 28 项,在每个规模下都排第二。本文说明它在哪些地方领先,在哪些地方落后,我们一路上修复了什么,以及你可以用来验证每个数字的那一个脚本。
Swarms 团队8 分钟阅读

我们把模型替换成桩,在九个智能体框架上运行同样的 100 智能体任务,再把规模扩大到 1,000 个智能体。Swarms 在 48 项对比中领先 28 项,在每个规模下都排第二。本文说明它在哪些地方领先,在哪些地方落后,我们一路上修复了什么,以及你可以用来验证每个数字的那一个脚本。
每个智能体框架都说自己很快,但很少有框架公布一个你能复现的数字。所以我们写了一个脚本,在九个框架上运行同样的任务。本文报告它输出的结果,包括 Swarms 没有排在第一的那些行。
参与测试的框架有:Swarms、LangGraph、LangChain、CrewAI、AutoGen、OpenAI Agents SDK、Pydantic AI、LlamaIndex 和 Agno。
运行一百个智能体时,大部分耗时都花在模型上。无论用哪个框架,这部分都一样。不同的是框架在调用前后所做的一切:构建智能体、调度它们、保存它们的状态。这部分由框架负责,所以我们测的就是这部分。
脚本把模型替换成一个桩:等待 0.2 秒,然后返回一个固定的字符串。之后每个框架:
每个框架都在独立的进程里测量,输出中有一行确认每个框架对每个智能体恰好调用了一次模型。基于线程的框架调用阻塞式的桩,异步框架则 await 异步的桩,这与它们各自使用真实模型客户端时的方式一致。Swarms 走的是它的异步路径,与最快的那些竞争框架一样:ConcurrentWorkflow.run() 在一个事件循环上 await 每个智能体。
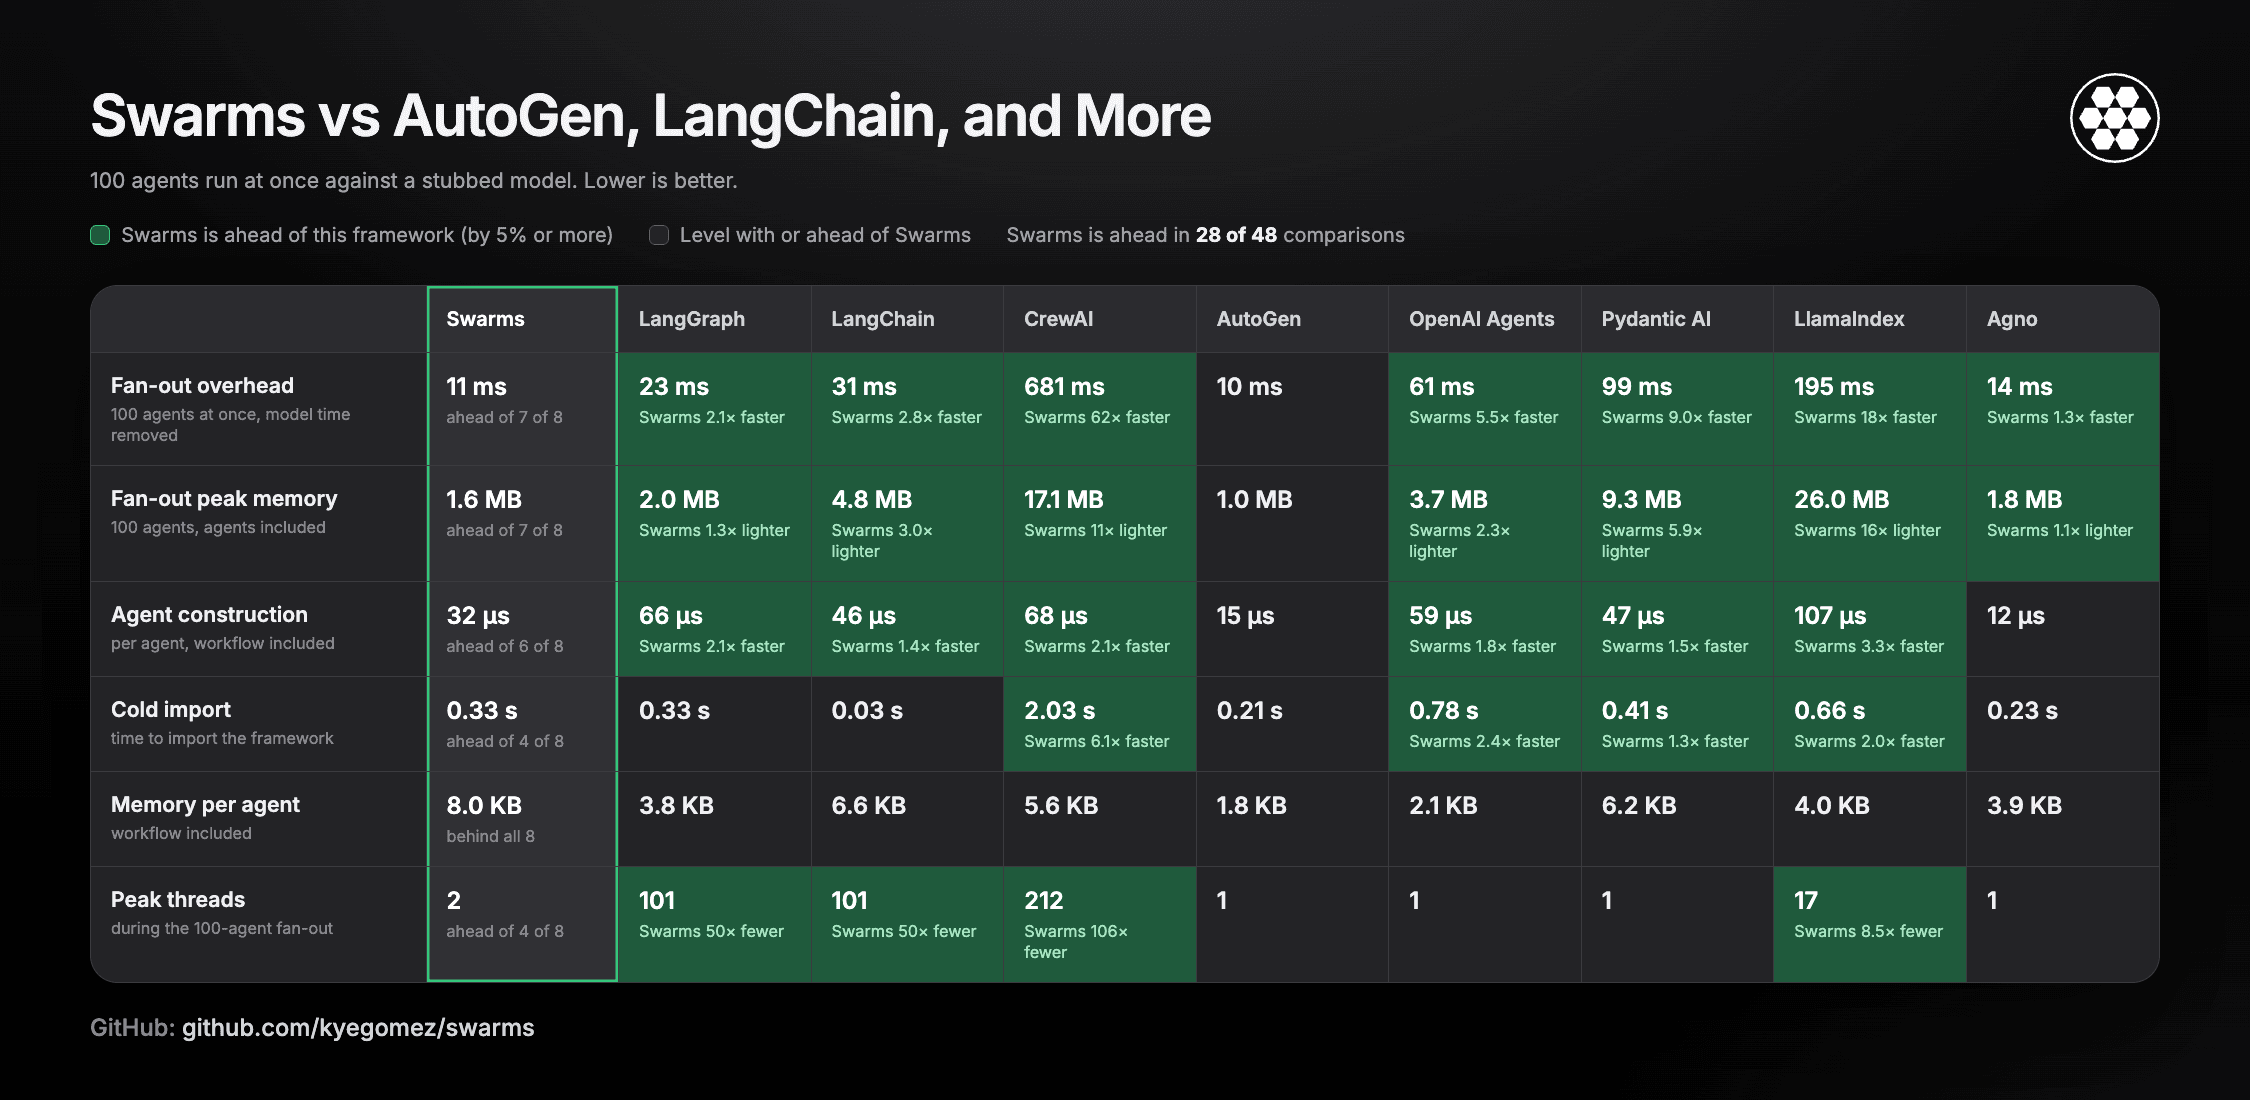
绿色表示在这一项对比中,Swarms 领先该框架 5% 或更多。在 48 项对比中 Swarms 领先 28 项。数字取三次运行的中位数。
| 指标 | Swarms | 领先的框架数 |
|---|---|---|
| 并发开销 | 11 ms | 8 个中的 7 个 |
| 并发峰值内存 | 1.6 MB | 8 个中的 7 个 |
| 智能体构建 | 32 µs | 8 个中的 6 个 |
| 冷启动导入 | 0.33 s | 8 个中的 4 个 |
| 峰值线程数 | 2 | 8 个中的 4 个 |
| 单个智能体内存 | 8.0 KB | 无 |
Swarms 领先的地方。 对一个集群来说最重要的数字是并发开销:许多智能体同时运行时框架额外增加的时间。Swarms 为 100 个智能体增加 11 ms。这比 LangGraph 少 2.1 倍,比 LangChain 少 2.8 倍,比 OpenAI Agents SDK 少 5.5 倍,比 Pydantic AI 少 9 倍,比 LlamaIndex 少 18 倍,比 CrewAI 少 62 倍。只有 AutoGen 与之持平,为 10 ms。运行期间的峰值内存也是同样的情况:Swarms 为 1.6 MB,Pydantic AI 为 9.3 MB,CrewAI 为 17.1 MB,LlamaIndex 为 26 MB,只有 AutoGen 更轻,为 1.0 MB。而且整个并发只用 2 个线程,而基于线程的框架每个智能体用一个线程。
Swarms 落后的地方。 单个 Swarms 智能体占用 8.0 KB,比这里任何其他框架的智能体都多。AutoGen 在每一行都领先于 Swarms 或与之持平,Agno 构建智能体更快。下文会回到内存这一点。
一百个智能体只是一个小集群。我们把同样的基准测试从 10 个智能体跑到 1,000 个,看看集群变大时会发生什么。
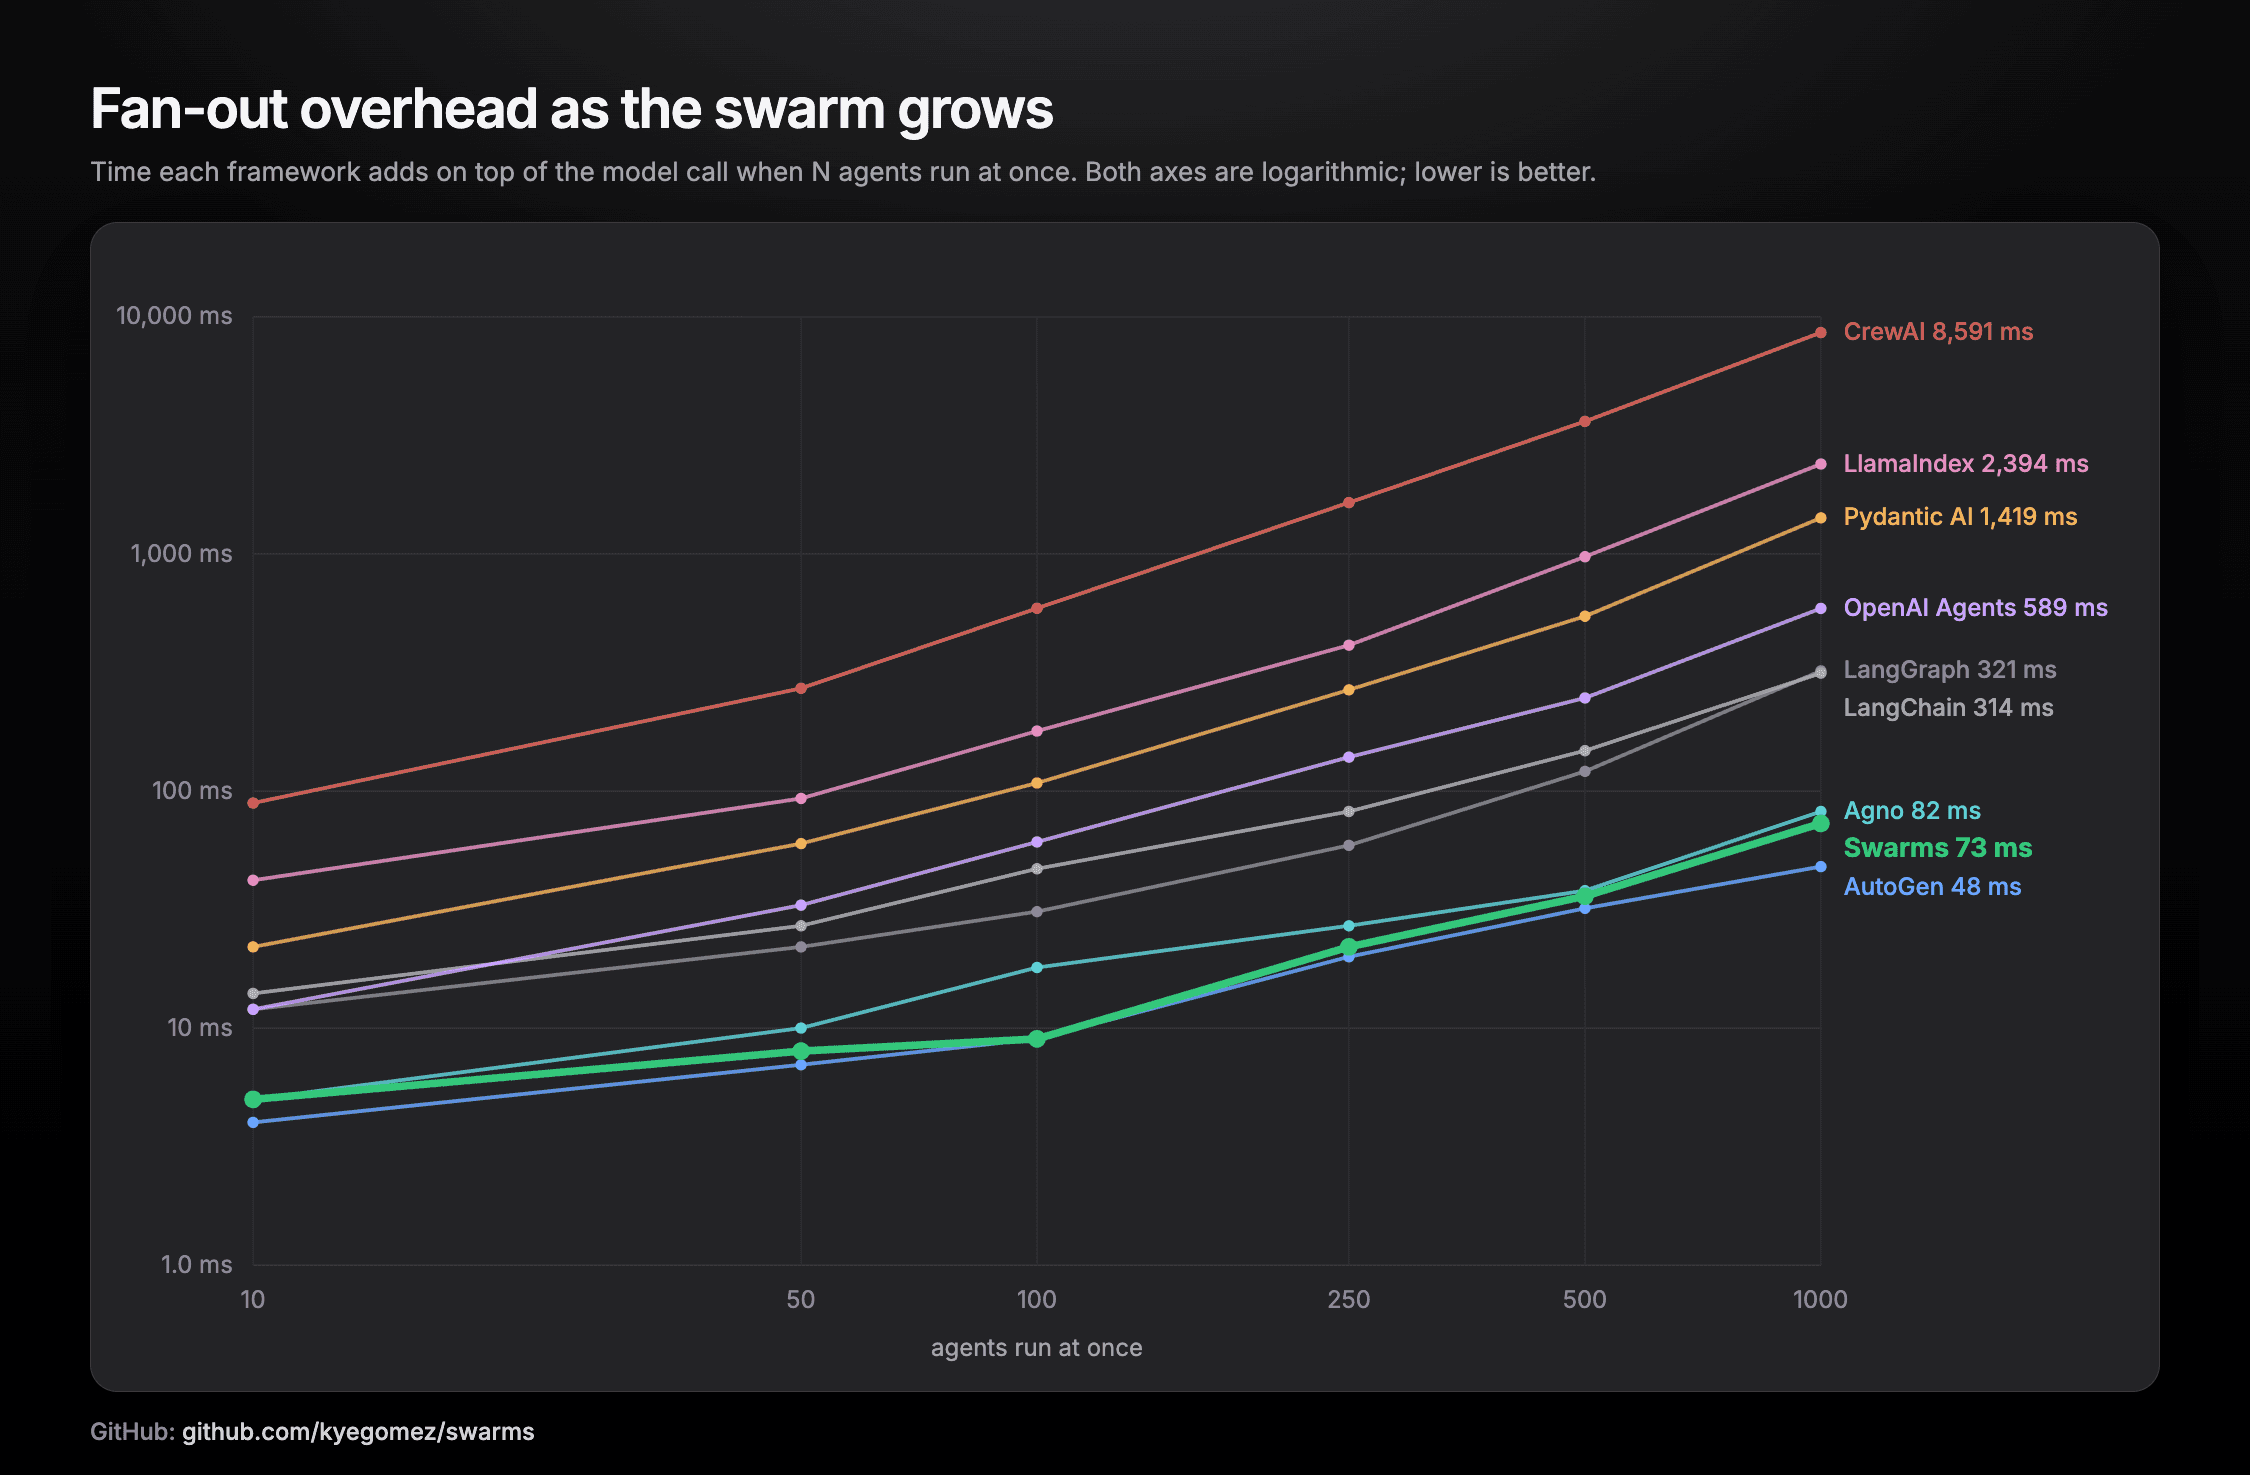
1,000 个智能体同时运行时,Swarms 增加 73 ms。它与大多数框架的差距随规模扩大而拉开:
| 框架 | 10 个智能体时的开销 | 1,000 个智能体时的开销 | 1,000 个时与 Swarms 相比 |
|---|---|---|---|
| AutoGen | 4 ms | 48 ms | 少 1.5 倍 |
| Swarms | 5 ms | 73 ms | |
| Agno | 5 ms | 82 ms | 多 1.1 倍 |
| LangChain | 14 ms | 314 ms | 多 4.3 倍 |
| LangGraph | 12 ms | 321 ms | 多 4.4 倍 |
| OpenAI Agents SDK | 12 ms | 589 ms | 多 8.1 倍 |
| Pydantic AI | 22 ms | 1,419 ms | 多 19 倍 |
| LlamaIndex | 42 ms | 2,394 ms | 多 33 倍 |
| CrewAI | 89 ms | 8,591 ms | 多 118 倍 |
在我们测量的每个规模下 Swarms 都排第二(10 个智能体时与 Agno 持平),扩展性好于八个框架中的七个。LangGraph 是一个清楚的例子:10 个智能体时它增加的时间是 Swarms 的 2.4 倍,到 1,000 个时是 4.4 倍。AutoGen 始终领先,它的优势从 100 个智能体时的基本持平扩大到 1,000 个时的 1.5 倍。
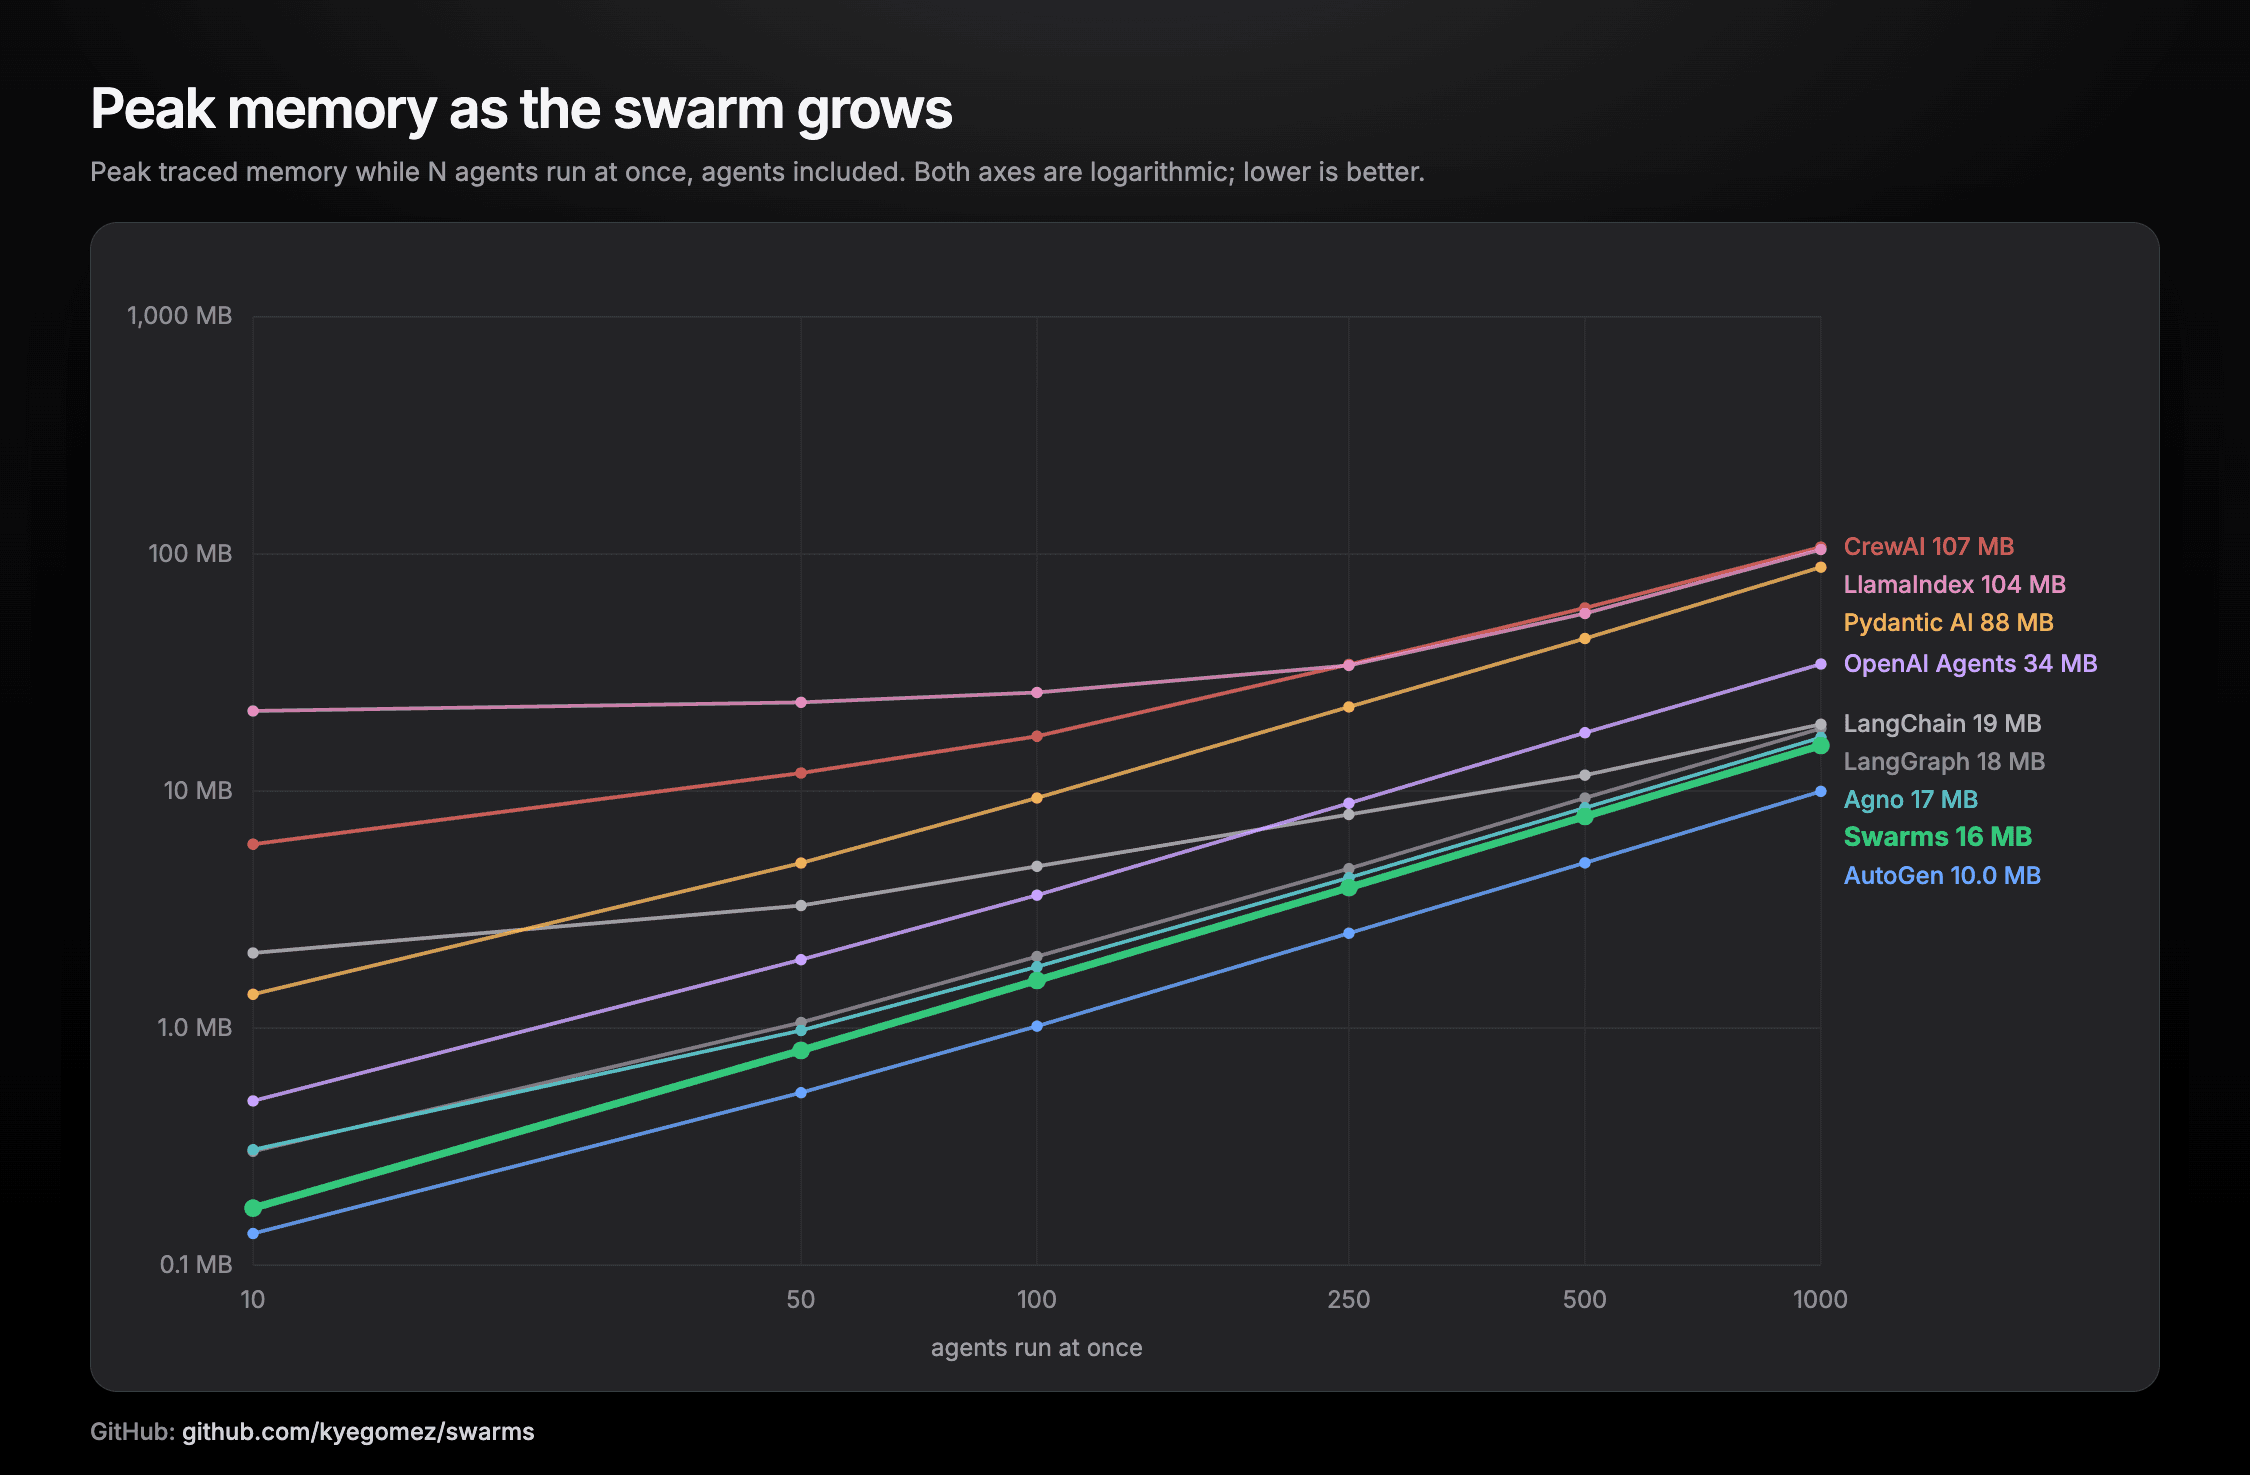
所有框架的内存都呈线性增长。1,000 个智能体时 Swarms 的峰值为 15.6 MB,仅次于 AutoGen 的 10 MB,领先于 Agno(16.8 MB)、LangGraph(18.4 MB)和 LangChain(19.1 MB)。OpenAI Agents SDK(34 MB)、Pydantic AI(88 MB)、LlamaIndex(104 MB)和 CrewAI(107 MB)则重得多。
扩展性的数字来自每个规模下的一次运行,所以小的差异应当视为噪声。这里 100 个智能体的那个点,Swarms 读数为 9 ms,而上面表格中的中位数是 11 ms。
第一次运行时,Swarms 在智能体构建上排倒数第二,在单个智能体内存上排最后,并且每个智能体占用一个线程。基准测试告诉了我们该看哪里,随后有三处改动:
ConcurrentWorkflow.run() 现在在一个事件循环上 await 它的智能体,所以模型调用在等待时不占用线程(#3414)。调用方式与以前完全相同。| 第一次运行 | 现在 | |
|---|---|---|
| 单个智能体的构建时间 | 180 µs | 32 µs |
| 单个智能体的内存 | 10.4 KB | 8.0 KB |
| 1,000 个智能体的并发开销 | 140 ms | 73 ms |
| 1,000 个智能体的峰值线程数 | 1,002 | 2 |
这就是公布一份包含自己弱项的基准测试的理由:你会知道弱项在哪里。
剩下的差距都有公开的跟踪:
c00c686ff。整个基准测试只有一个文件,tests/benchmark.py。它不需要 API 密钥。没有安装的框架会显示为 not installed,所以装了哪些就能跑哪些。
git clone https://github.com/kyegomez/swarms.git && cd swarms
pip install -e .
pip install langgraph langchain-core crewai autogen-agentchat "autogen-ext[openai]" \
  openai-agents pydantic-ai-slim llama-index-core agno

PYTHONPATH=. python tests/benchmark.py
PYTHONPATH=. python tests/benchmark.py --agents 1000
如果你的数字与我们的不一致,或者你认为某个适配器对某个框架不公平,请提交 issue。每个适配器大约二十行,我们宁愿被纠正,也不愿意出错。
Swarms 是开源的,这个基准测试是它不断变好的方式之一。如果它对你有用:
文档在 docs.swarms.world。
本周我们重做了 swarms.world 的页面交付方式。41 个页面现在预先渲染并由 CDN 提供,大多数页面加载的 JavaScript 减少了约四分之一,应用也升级到了 Next.js 16 和 React 19。本文介绍改了什么,以及我们测到了什么。
Google 的 gemini-decision-1 用经过校准的概率回答是非、选择和评分问题,输出 token 为零。本文介绍如何在开源 Swarms 框架中用 DecisionModel 调用它,以及如何用它在智能体之间路由请求。
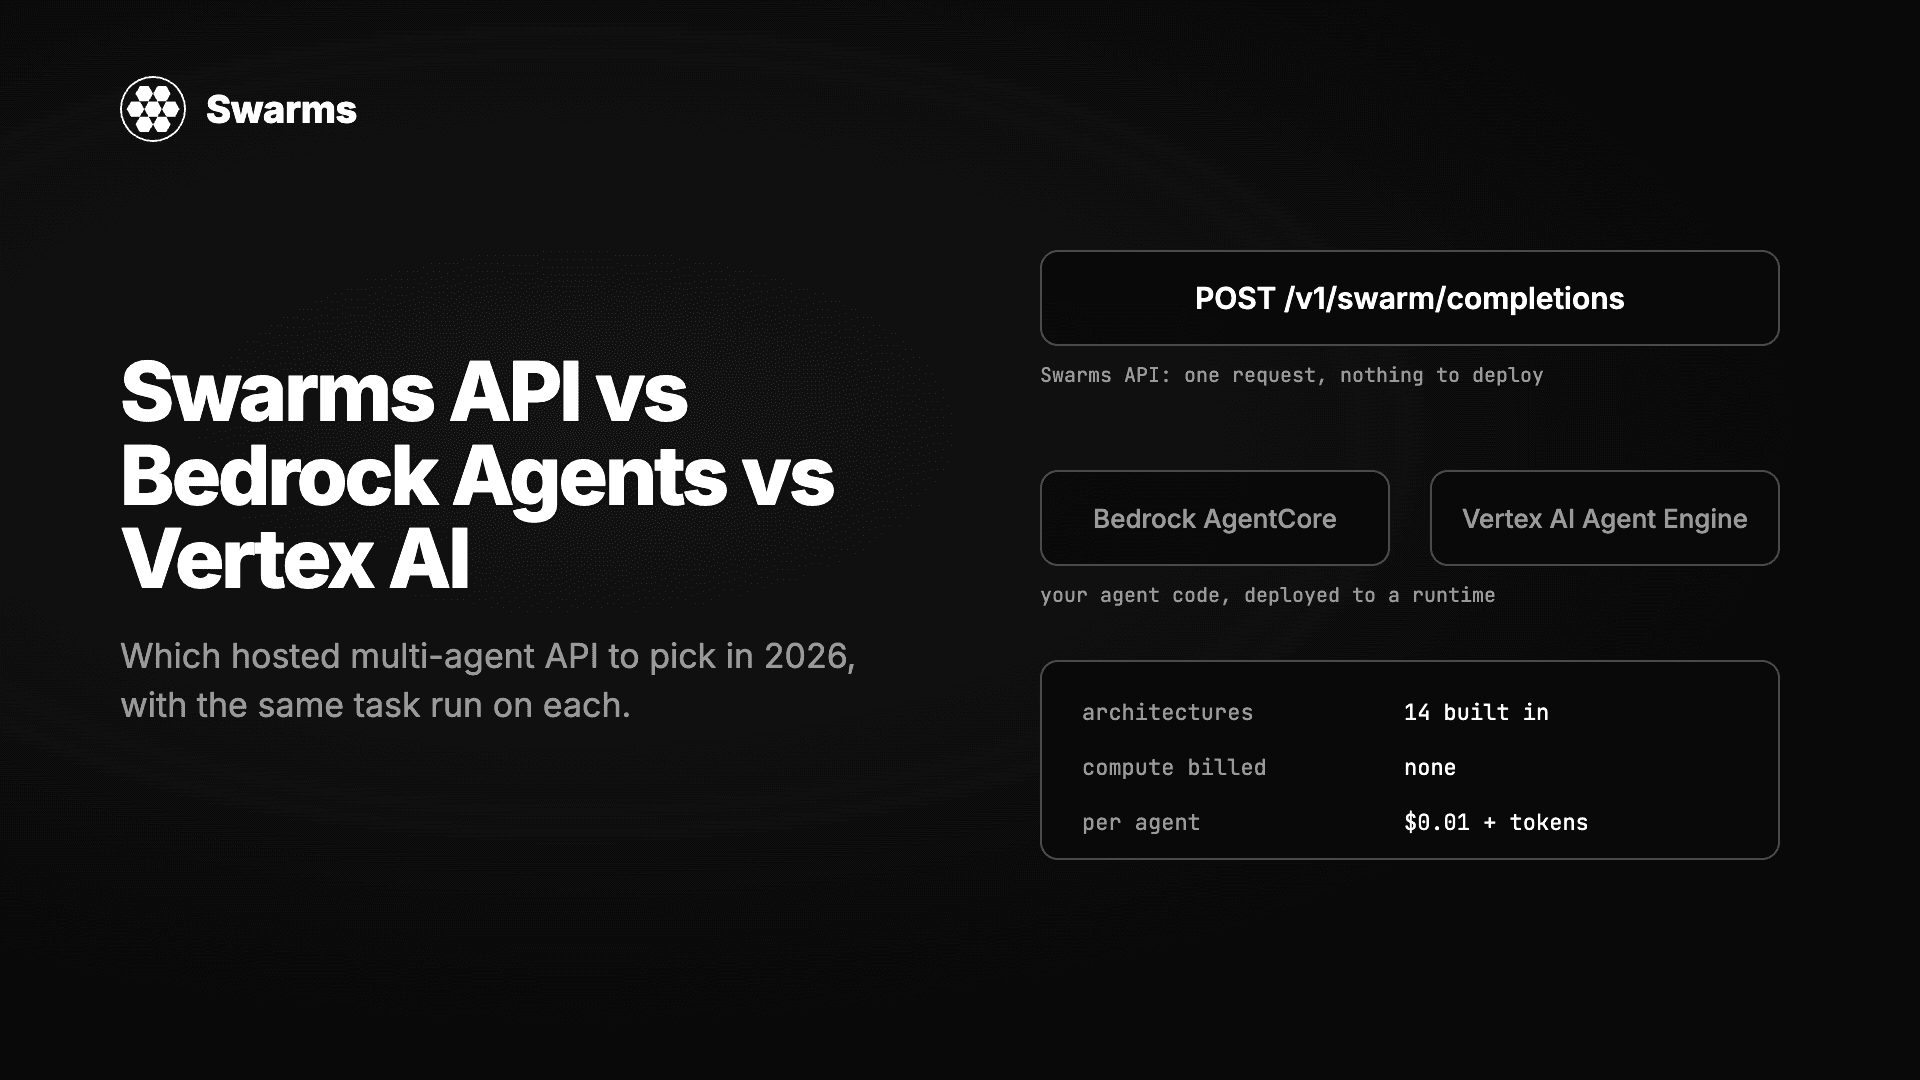
三种无需自建服务器即可运行多智能体系统的方式实测对比:Swarms API、Amazon Bedrock Agents 与 AgentCore、Google 的 Vertex AI Agent Builder 与 ADK。同一任务分别实现,逐项比较架构、模型选择、流式输出、批处理、定价以及拿到第一个结果所需的时间。