指南工程
LLM 智能体的编排者-工作者模式:扇出到数百个工作者
Python 中 LLM 智能体的编排者-工作者(orchestrator worker)模式:PhasedFanOutWorkflow 让主智能体先规划并校验工作,再扇出到数百个工作者智能体。
Kye Gomez11 分钟阅读

Python 中 LLM 智能体的编排者-工作者(orchestrator worker)模式:PhasedFanOutWorkflow 让主智能体先规划并校验工作,再扇出到数百个工作者智能体。
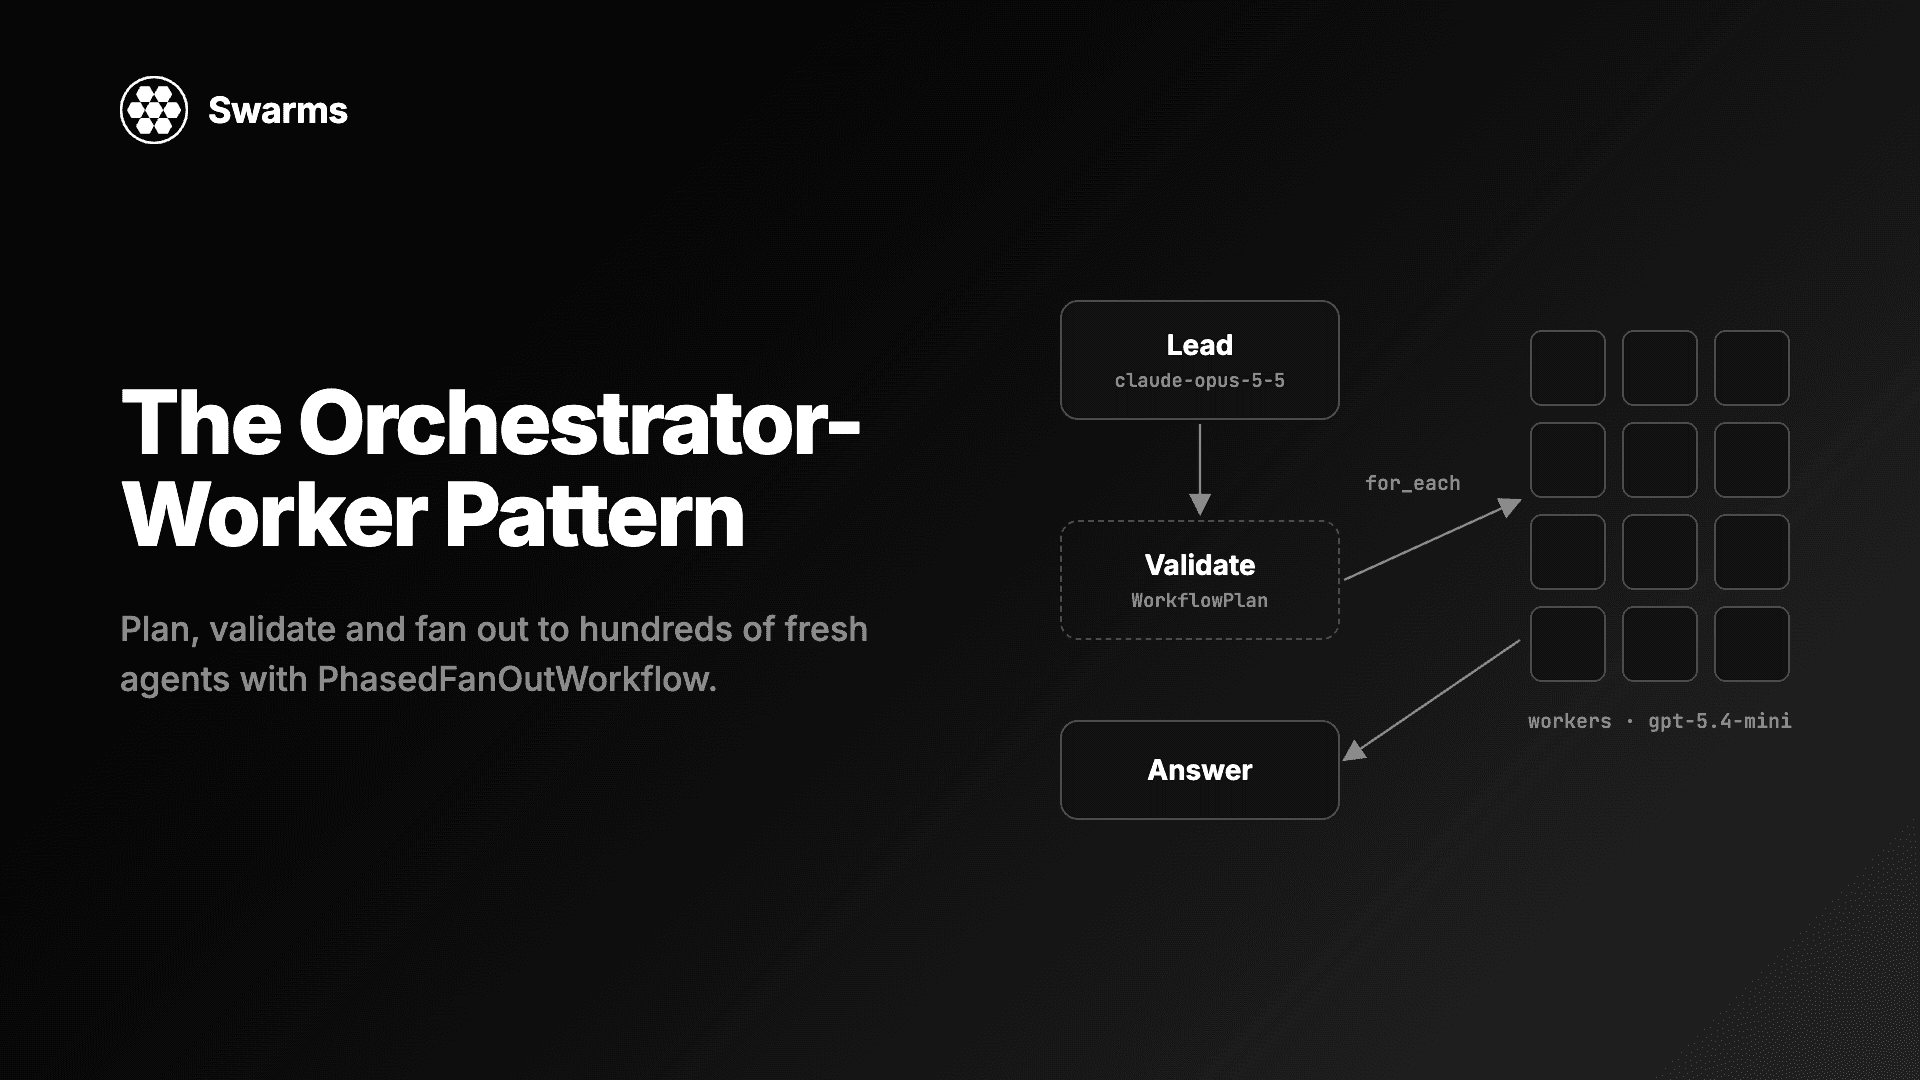
LLM 智能体的编排者-工作者模式(orchestrator-worker pattern)把一项工作分给两类角色:一个负责规划的主模型,以及许多各自只做一小块的工作者智能体。当工作量要到运行时才知道有多宽时,这就是合适的结构,例如“找出这些文件里的每个 bug,再逐个验证”,或者“分拣这个队列里的每张工单”。本指南先解释这个模式,再演示如何在 Python 中用 PhasedFanOutWorkflow 运行它,它随 Swarms v17 “InterLink” 发布。主智能体写出计划,计划在任何工作者启动前先经过校验,然后运行按数据需要扇出到相应数量的全新工作者智能体(只要你允许,可以是数百个),最后主智能体根据结果写出最终答案。下面的每个代码块在发布前都针对 Swarms 17.0.0 源码实际运行过。
这个模式有三步:
它的价值来自隔离和宽度。让单个智能体审查 40 个文件,它会在一个上下文里读完 40 个文件,然后开始走马观花。换成 40 个工作者,每个只拿一个文件,每个都会仔细读自己的文件,而且它们同时运行。之后再为每条发现配一个验证者,独立于提出该结论的智能体去检查它。
固定宽度的扇出(宽度由你自己连好)是另一种工具。如果你每次都运行同样的五个分析师,ConcurrentWorkflow 或 GraphWorkflow 更简单也更便宜,因为不需要任何模型来做规划。只有当工作者的数量取决于输入时,编排者-工作者模式多出来的那次规划调用才值得。更广泛的层级式设计,可以参考管理者-工作者智能体架构和智能体编排模式。
PhasedFanOutWorkflow(位于 swarms/structs/phased_fan_out_workflow.py)分四个阶段运行:
WorkflowPlan:可选的内联智能体、有序的阶段列表,以及它希望拿回输出的步骤。计划只是普通数据,运行时从不执行模型写出的任何内容。{item}、for_each 指向的字段在源步骤的 output_schema 中没有声明为数组、没有任何占位符的步骤(它的智能体将看不到任何材料)、同一阶段中重复的步骤,以及静态智能体数量。被拒绝的计划会连同错误列表一起退回给主智能体,最多 max_plan_attempts 次。max_concurrent_agents 限制。for_each 步骤会为更早步骤返回的列表中的每一项启动一个全新的智能体。return_steps 中步骤的输出,并写出最终答案。| 字段 | 内容 |
|---|---|
name、description | 简短名称,以及对方法的一句话概述 |
inline_agents | 主智能体为本次运行定义的智能体,每个包含 name 和 system_prompt |
phases | 有序列表;每个阶段有 title 和并行运行的 steps |
return_steps | 主智能体合并时读取其输出的步骤 id |
每个步骤有 id、agent(预定义或内联智能体的名称)、prompt,以及两个可选字段:
for_each:"<step_id>.<field>"。对该列表中的每个元素各运行一个智能体。如果源步骤本身就是扇出,它所有槽位的列表会合并成一个。output_schema:一个 JSON schema。工作者会被要求返回符合它的 JSON,回复在下一阶段看到之前就会被解析。被其他步骤扇出的步骤,必须在这里把它的列表字段声明为 "type": "array"。提示中可以使用三类占位符:{task}(原始任务,逐字插入)、{item}(当前项,仅用于 for_each 步骤)以及 {step_id}(更早阶段某个步骤的输出,结构化输出会以 JSON 插入)。
pip install -U swarms
# optional: RouteHub for lower per-call overhead, rustworkx for graphs
pip install -U "swarms[fast]"
示例混用了多家提供商,所以每家都需要在环境变量中设置 key:OPENAI_API_KEY、ANTHROPIC_API_KEY、GEMINI_API_KEY、DEEPSEEK_API_KEY、MISTRAL_API_KEY 和 GROQ_API_KEY,或者只设置你保留的模型对应的那些。
三个小文件,每个都埋了一个 bug。主智能体决定如何拆分审查,工作者负责阅读。
from swarms.structs.phased_fan_out_workflow import PhasedFanOutWorkflow

FILES = {
    "billing.py": """
def apply_discount(price, percent):
    # percent is 0-100, e.g. 15 for 15%
    return price - price * percent
""",
    "dates.py": """
from datetime import datetime

def days_between(start, end):
    delta = datetime.fromisoformat(end) - datetime.fromisoformat(start)
    return delta.seconds // 86400
""",
    "cache.py": """
def get_user(cache, user_id, load):
    if user_id in cache:
        return cache[user_id]
    user = load(user_id)
    return user
""",
}

task = (
    "Find every bug in these files, verify each one independently, "
    "and report only the confirmed bugs with a one-line fix.\n\n"
    + "\n\n".join(f"=== {name} ===\n{code}" for name, code in FILES.items())
)

workflow = PhasedFanOutWorkflow(
    model_name="anthropic/claude-opus-5-5",  # lead: plans and combines
    worker_model_name="gpt-5.4-mini",        # every inline worker agent
    size_guideline="small",
)

print(workflow.run(task))
model_name 用来构建主智能体。worker_model_name 是主智能体定义的每个内联智能体所用的模型;如果省略,工作者会使用主智能体的模型,这通常是昂贵的选择。这里的分工是有意的:规划和综合只有几次调用,却决定了整次运行的质量,所以交给强模型(Claude Opus 5.5);大量范围很窄的工作者调用交给另一家提供商的便宜快速模型(gpt-5.4-mini)。使用两家提供商还意味着工作者的突发请求不会占用主智能体的速率限额。
run() 以字符串形式返回主智能体的最终答案(工作流的 output_type 默认是 "final")。每个智能体完成时也会打印一个面板。这个任务的典型计划有三个阶段:一个智能体列出文件,一次扇出让每个智能体审查一个文件,第二次扇出让每个智能体验证一个报告的 bug。三个文件一共七个工作者智能体。v17 发布说明报告,仓库中的 bug 排查示例在真实模型上运行时,用大约 14,000 个 token 找到并确认了全部三个埋入的 bug。
工作流会保留上一次运行的全部信息。接着上面的代码块继续:
plan = workflow.last_plan
for phase in plan.phases:
    for step in phase.steps:
        fan = f" (one agent per item of {step.for_each})" if step.for_each else ""
        print(f"{phase.title}: {step.id} -> {step.agent}{fan}")

run = workflow.last_run
print("worker agents:", run["agent_count"])
print("failed slots:", run["failures"])
print("verdicts:", [v["verdict"] for v in run["outputs"]["verify"]])
print("tokens:", workflow.usage)
对于上面描述的三阶段计划,它会打印:
Discover: list_files -> indexer
Hunt: hunt -> bug_hunter (one agent per item of list_files.files)
Verify: verify -> verifier (one agent per item of hunt.bugs)
worker agents: 7
failed slots: []
verdicts: ['confirmed', 'confirmed', 'confirmed']
tokens: {'input_tokens': ..., 'output_tokens': ..., 'cached_tokens': ..., 'reasoning_tokens': ..., 'total_tokens': ...}
步骤 id 和智能体名称由主智能体自己决定,所以你看到的会不同。可以依赖的是:
last_plan 是经过校验的 WorkflowPlan(一个 Pydantic 模型),所以 last_plan.model_dump_json(indent=2) 能给出完整计划,便于记录日志或在多次运行之间对比。last_run["outputs"] 把每个步骤 id 映射到它的输出。带 output_schema 的步骤保存解析后的 JSON;扇出步骤保存一个列表,每项对应一个条目。last_run["agent_count"] 统计启动的工作者智能体数量(不含主智能体)。last_run["agents"] 保存用到的每个智能体实例,包括主智能体和重试。last_run["failures"] 列出重试之后仍然失败的扇出槽位,带有阶段、步骤、项和错误。usage 汇总主智能体和每个工作者实例上提供商报告的 token,结构与 Agent.usage 相同。要把它换算成美元,请参阅如何在 Python 中追踪 LLM token 用量和成本。内联智能体很方便,但有时你想用自己配置并测试过的工作者。用 agents=[...] 传入它们,并设置 allow_inline_agents=False,让主智能体只能使用它们。主智能体规划时会看到每个智能体的 agent_name 和 agent_description,所以描述要写给规划者看。
from swarms import Agent
from swarms.structs.phased_fan_out_workflow import PhasedFanOutWorkflow

reader = Agent(
    agent_name="Clause-Reader",
    agent_description="Reads one contract and quotes every change-of-control clause.",
    system_prompt=(
        "You read a single contract and quote, word for word, every clause "
        "triggered by a change of control. If there is none, return an empty list."
    ),
    model_name="deepseek/deepseek-v4-pro",
    max_loops=1,
)
checker = Agent(
    agent_name="Clause-Checker",
    agent_description="Independently checks whether a quoted clause is a change-of-control clause.",
    system_prompt=(
        "You are a skeptical contracts lawyer. Decide whether the quoted clause "
        "is really triggered by a change of control, and explain why."
    ),
    model_name="mistral/mistral-large-latest",
    max_loops=1,
)

contracts = {
    "acme_supply.txt": (
        "12.1 Either party may terminate this Agreement on 30 days notice. "
        "12.4 If Supplier undergoes a change of control, Buyer may terminate immediately."
    ),
    "globex_license.txt": (
        "8.2 This license may not be assigned without consent, including by merger "
        "or sale of a majority of the Licensee's shares."
    ),
}
task = "Quote every change-of-control clause in these contracts and confirm each one.\n\n" + "\n\n".join(
    f"=== {name} ===\n{text}" for name, text in contracts.items()
)

workflow = PhasedFanOutWorkflow(
    model_name="gpt-5.4",
    agents=[reader, checker],
    allow_inline_agents=False,
    size_guideline="small",
)
print(workflow.run(task))
print(sorted({agent.model_name for agent in workflow.last_run["agents"]}))最后一行打印本次运行用到的三个模型:deepseek/deepseek-v4-pro、gpt-5.4 和 mistral/mistral-large-latest。阅读者和检查者有意来自不同的提供商,这样验证者就不会和产生结论的模型共享同样的盲点。
预定义智能体保留它们自己的 model_name;worker_model_name 只作用于内联智能体。每次使用预定义智能体,都会根据它的构造参数重建一个新实例(Agent 无法被深拷贝),所以不会有对话状态在步骤之间或运行之间延续。发布说明报告,这个合同审查示例在真实模型上三次运行三次都找到并引用了两条控制权变更条款。
宽度正是这个模式的价值所在。这里 200 张客服工单各自分配一个分拣智能体。主智能体是 Gemini 2.5 Pro;200 个工作者在 Groq 上运行 gpt-oss-120b,单次调用又快又便宜。
import random

from swarms.structs.phased_fan_out_workflow import (
    PhasedFanOutWorkflow,
    PhasedFanOutWorkflowError,
)

# A stand-in for a support-queue export: 200 one-line tickets.
random.seed(7)
issues = [
    "Card was charged twice this month",
    "Cannot log in after password reset",
    "CSV export times out on large projects",
    "Please add a dark mode",
    "Invoice shows the wrong VAT rate",
    "App crashes when uploading a photo",
]
tickets = [f"T-{n:03d}: {random.choice(issues)}" for n in range(1, 201)]

task = (
    "Triage every ticket below. Give each one a category (billing, auth, bug, "
    "feature) and an urgency (low, medium, high), then summarise the queue.\n\n"
    + "\n".join(tickets)
)

workflow = PhasedFanOutWorkflow(
    model_name="gemini/gemini-2.5-pro",           # lead
    worker_model_name="groq/openai/gpt-oss-120b",  # 200 cheap, fast workers
    size_guideline="unrestricted",
    max_agents=250,             # hard ceiling on workers per run
    max_concurrent_agents=64,   # workers calling the model at once (1 to 256)
    max_retries=1,              # one retry per worker, with a fresh agent
    max_plan_attempts=3,
)

try:
    print(workflow.run(task))
except PhasedFanOutWorkflowError as error:
    print("run stopped:", error)

print("workers:", workflow.last_run["agent_count"])
print("failed slots:", len(workflow.last_run["failures"]))
如果计划用一个步骤拆分队列、再对结果扇出,这次运行会启动 201 个工作者:一个拆分者和 200 个分拣者。在这种宽度下,关键的参数是:
| 参数 | 默认值 | 控制什么 |
|---|---|---|
size_guideline | "medium" | 告诉主智能体的目标规模:small(少于 5 个智能体)、medium(少于 10 个)、large(少于 50 个)、unrestricted(在硬上限内按任务需要使用) |
max_agents | 1000 | 每次运行的工作者硬上限。会超过上限的扇出在它的任何智能体启动前就会停止 |
max_concurrent_agents | 16 | 一个阶段内同时运行的工作者数;必须在 1 到 256 之间 |
max_retries | 2 | 失败工作者的重试次数,每次都用全新的智能体 |
max_plan_attempts | 3 | 主智能体可以写的计划次数,超过后运行会抛出 PhasedFanOutWorkflowError |
默认的 size_guideline="medium" 会让主智能体控制在 10 个智能体以内,所以想要真正的宽度时要调高它。max_agents 是安全网:设为 max_agents=150 时,同样的运行会在发出任何一次分拣调用之前停止,并报出 Phase 'Triage' needs 200 agents, which would pass max_agents=150 (1 already run)。max_concurrent_agents 是节流阀;根据工作者模型所在提供商的速率限制来设置它,因为 200 个工作者都打在同一个账号上。
注意每个工作者的提示里放了什么。收到 {task} 的工作者会拿到整个原始任务,所以 200 个工作者每个都读一遍 200 张工单的队列,输入 token 会乘以 200。这里拆分者把工单作为列表返回,每个分拣者只通过 {item} 收到自己的那张工单。主智能体的规划提示也会引导它优先采用这种结构。
不同类型的步骤失败时表现不同。失败的扇出槽位在输出中变成 None,并列在 last_run["failures"] 中,运行继续;主智能体会被告知 null 条目是失败的智能体,并报告缺口。失败的单一步骤(没有 for_each)会抛出 PhasedFanOutWorkflowError,因为后续阶段会缺少输入。
校验器是一个普通方法,所以你可以在手写的计划上运行它。这个计划有好几处错误:
from swarms.structs.phased_fan_out_workflow import (
    PhasedFanOutWorkflow,
    WorkflowPlan,
)

workflow = PhasedFanOutWorkflow(model_name="gpt-5.4", worker_model_name="gpt-5.4-mini")

bad_plan = WorkflowPlan.model_validate({
    "name": "broken",
    "description": "A plan with several mistakes.",
    "inline_agents": [{"name": "worker", "system_prompt": "You do one unit of work."}],
    "phases": [
        {"title": "List", "steps": [
            {"id": "list", "agent": "worker", "prompt": "List the sections of {task}.",
             "output_schema": {"type": "object", "properties": {"sections": {"type": "array"}}}},
        ]},
        {"title": "Work", "steps": [
            {"id": "summarise", "agent": "worker", "prompt": "Summarise {item}."},
            {"id": "check", "agent": "worker", "for_each": "list.pages", "prompt": "Check {item}."},
            {"id": "polish", "agent": "editor", "prompt": "Polish the summary."},
        ]},
    ],
    "return_steps": ["summarise", "check", "polish"],
})

for problem in workflow.validate_plan(bad_plan):
    print("-", problem)
它不发出任何模型调用,并打印:
- Step 'summarise' uses {item} without for_each.
- Step 'check' for_each field 'pages' is not declared in the output_schema of 'list'.
- Step 'polish' uses unknown agent 'editor'.
- Step 'polish' has no {task}, {item} or {step_id} placeholder, so its agent sees none of the task's material. Add {task} or an earlier step's output.
在 run() 期间,这些信息会原样退回给主智能体:先是 “Your plan was rejected for these reasons”,然后是错误列表和原始规划请求。主智能体通常在第二次尝试时就能修正。无法解析或不符合 schema 的 JSON 也算一次被拒绝的尝试;带代码围栏、或在 JSON 之后多了一行收尾文字的回复,仍然会被接受。
gpt-5.4-mini、Claude Haiku 5.5 或 Groq 上的 gpt-oss-120b 做工作者,质量花在关键处,成本省在量大处。temperature 和 top_p,Opus 5.5 拒绝所有采样参数。工作流自带的主智能体和内联智能体都不设置这些参数。run(task, img=...) 会在规划时把图片传给主智能体;工作者只看到它们自己的提示。last_plan 是你成本最低的调试工具。一次运行给出糟糕答案时,计划通常能说明原因:扇出用错了列表、验证者从没看到证据、return_steps 跳过了已验证的结果。一个编排者模型把任务拆成若干工作单元,许多工作者智能体各自用一个范围很窄的提示并行处理一个单元,编排者再合并它们的结果。它适合宽度取决于输入的任务,例如审查每个文件或检查每条发现。
两者是近亲。在 PhasedFanOutWorkflow 中,编排者事先把整个计划写成经过校验的数据,由代码在阶段之间传递输出,所以主智能体从不读取中间结果。逐轮委派的管理者可以对每个结果做出反应,代价是它要读每个结果,上下文会随运行的宽度增长。
每次运行最多 max_agents 个(默认 1000),一个阶段内同时运行的最多 max_concurrent_agents 个(默认 16,最大 256)。size_guideline 告诉主智能体目标是多少;运行数百个工作者时把它设为 "unrestricted"。
可以。model_name 设置主智能体,worker_model_name 设置每个内联工作者。通过 agents=[...] 传入的预定义智能体保留它们自己的模型,所以一次运行可以混用多家提供商。
它会用全新的智能体重试,最多 max_retries 次。仍然失败的扇出槽位变成 None,记录在 last_run["failures"] 中,运行继续。仍然失败的单一步骤会抛出 PhasedFanOutWorkflowError。
pip install -U swarms然后从 swarms.structs.phased_fan_out_workflow 导入 PhasedFanOutWorkflow,给它一个强主模型和一个便宜的工作者模型,并在第一次运行后查看 last_plan。完整的功能说明,包括校验和 JSON 解析修复背后的 PR,见 Swarms v17 “InterLink” 更新日志。如果你已经知道需要多少个智能体,请阅读如何在 Python 中并行运行 100 个 AI 智能体。bug 排查和合同审查示例位于 Swarms 仓库的 examples/multi_agent/phased_fan_out_workflow/,参考文档在 docs.swarms.world。
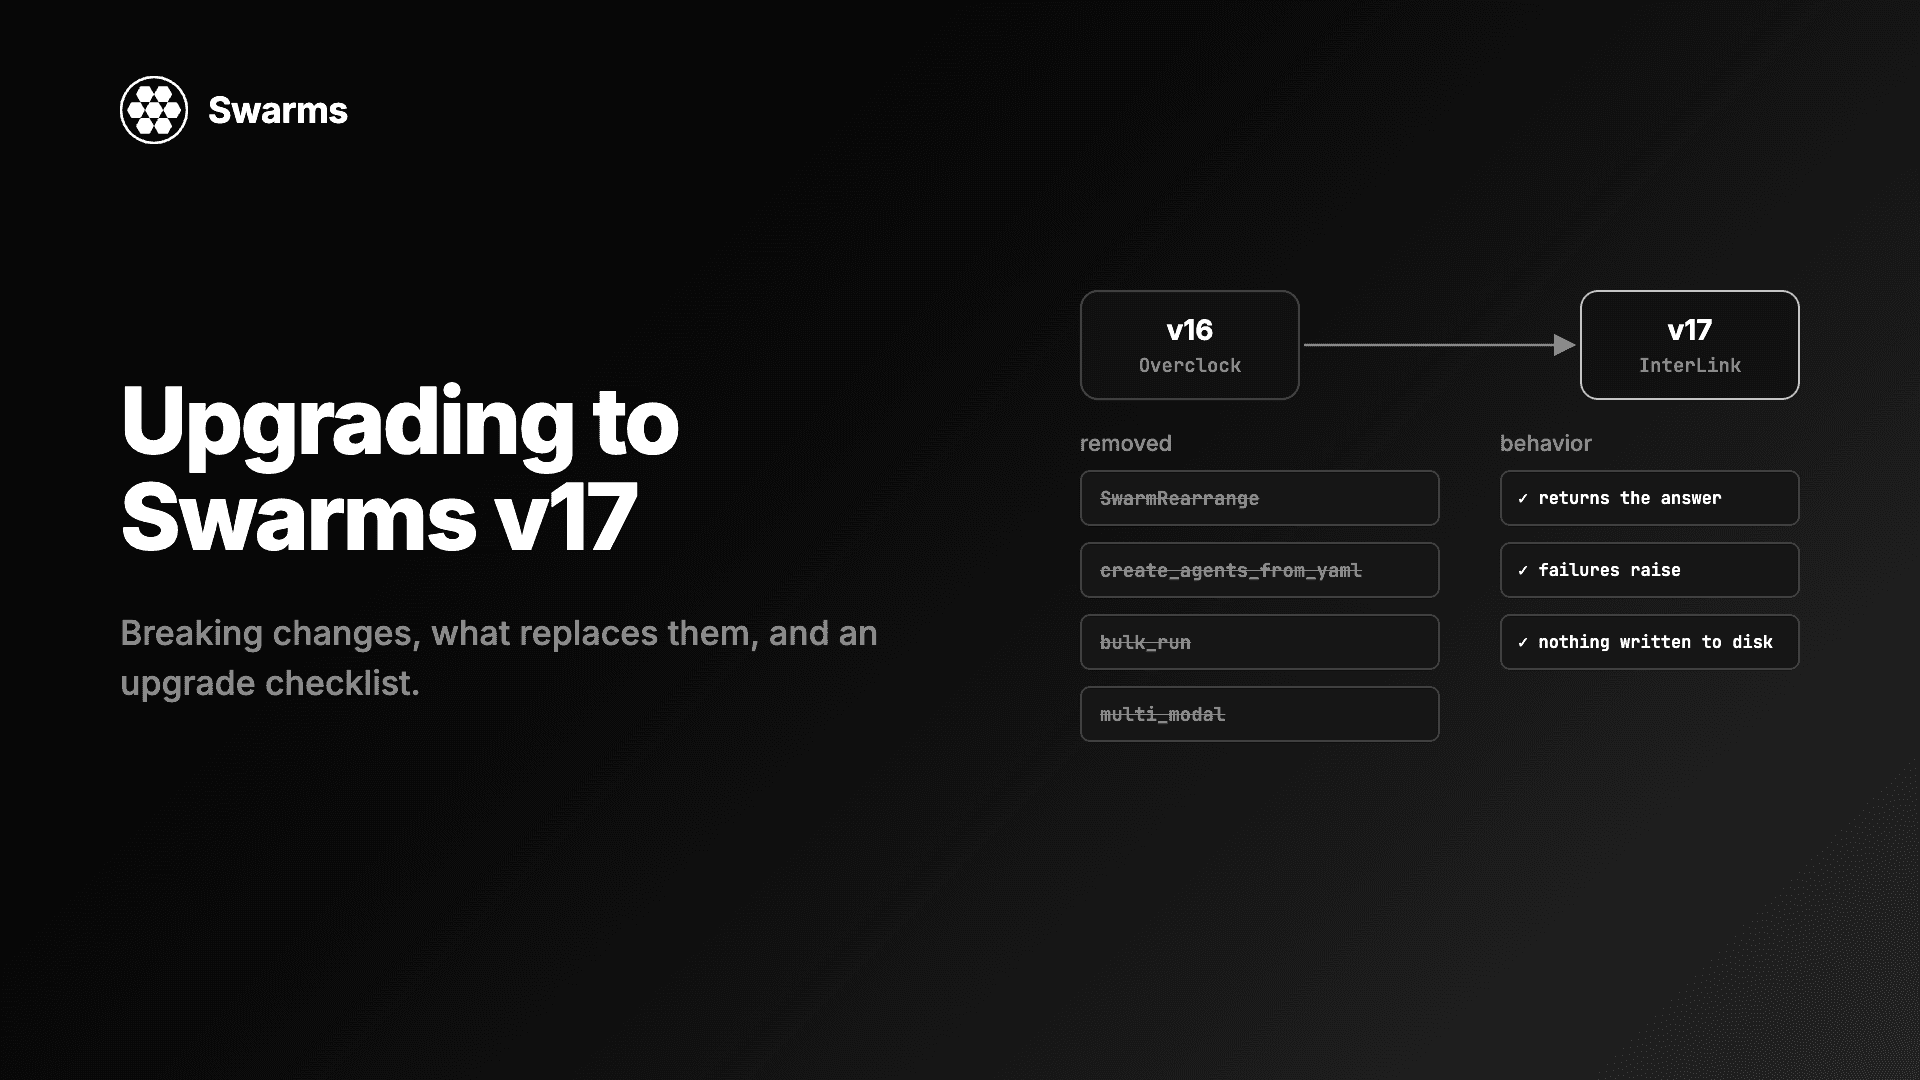
Swarms v17 升级与迁移指南:InterLink 中移除的每个类和参数、应该改用什么、变更的默认行为,以及一份升级检查清单。
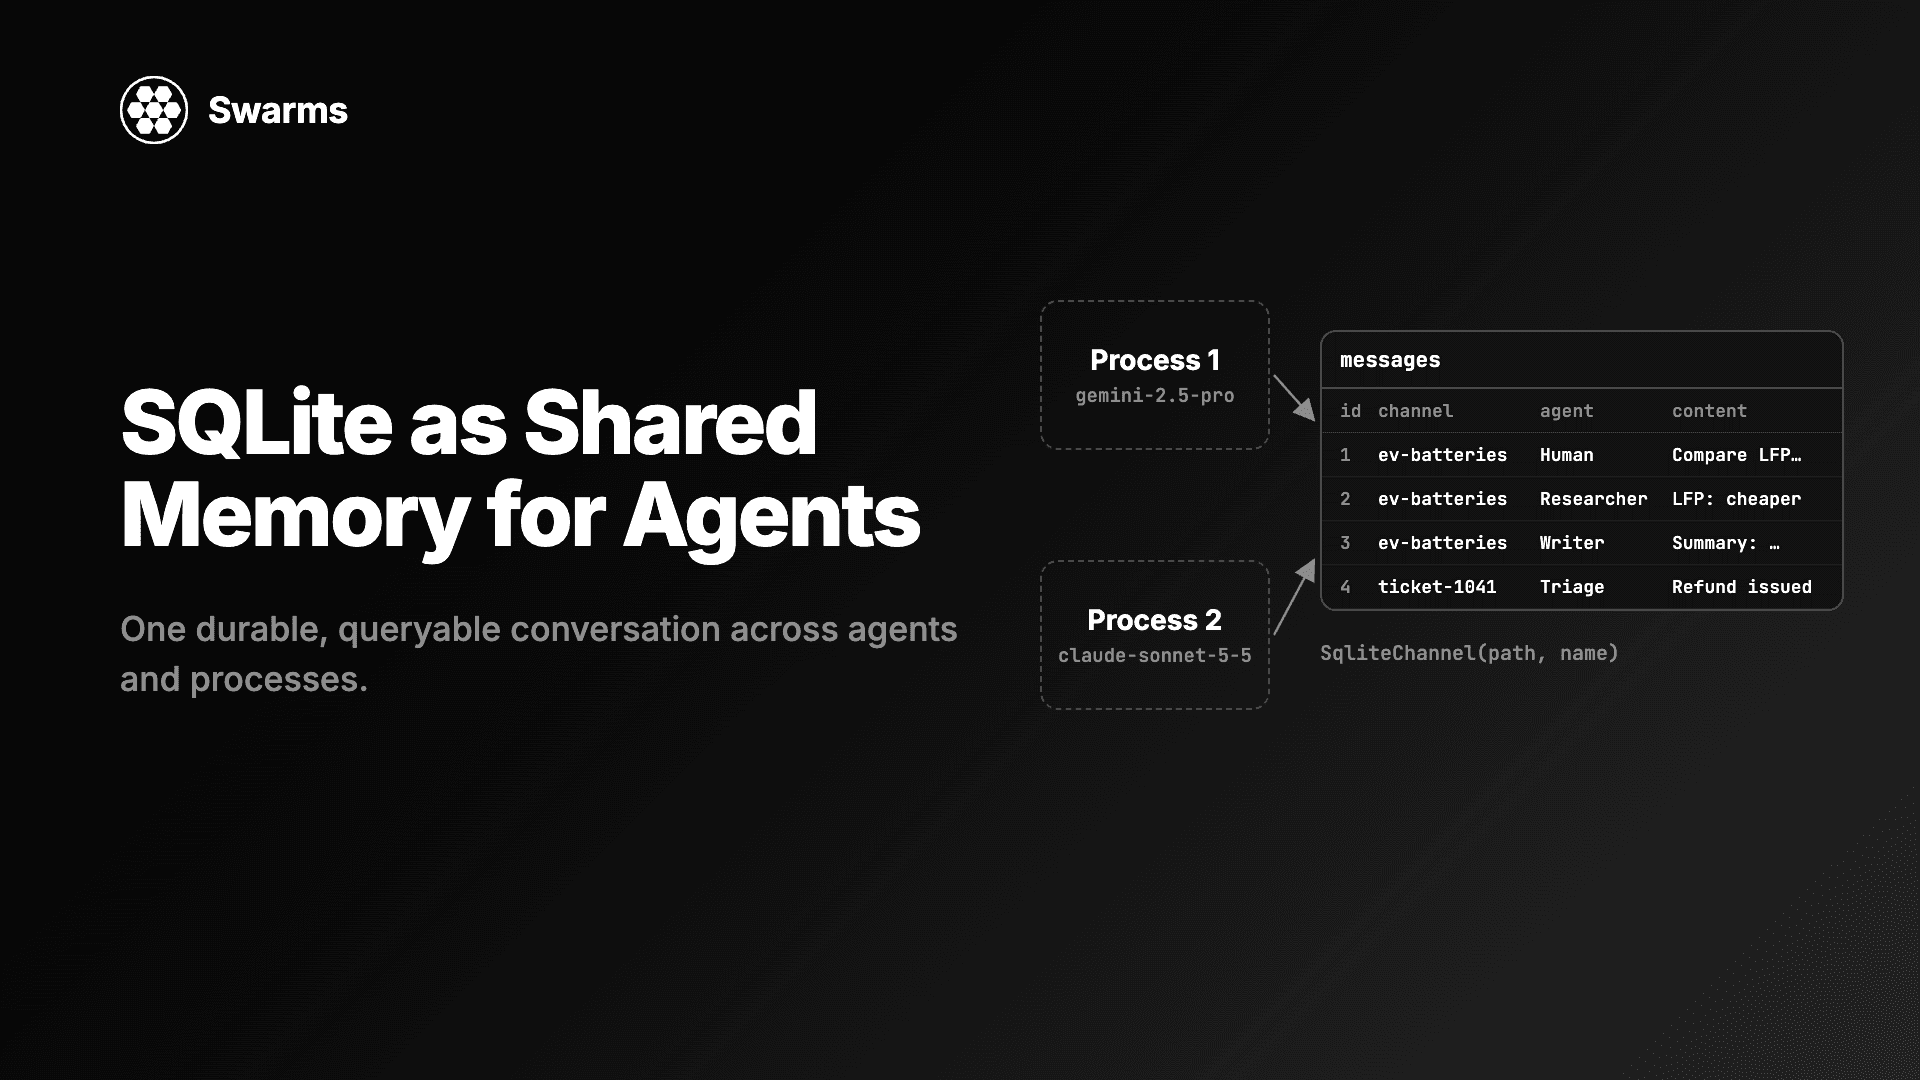
用 SQLite 实现 AI 智能体的共享记忆:SqliteChannel 让多个智能体和进程共用一份持久、可查询的对话历史。用 Swarms 存储、共享这份记忆,并对它运行 SQL。
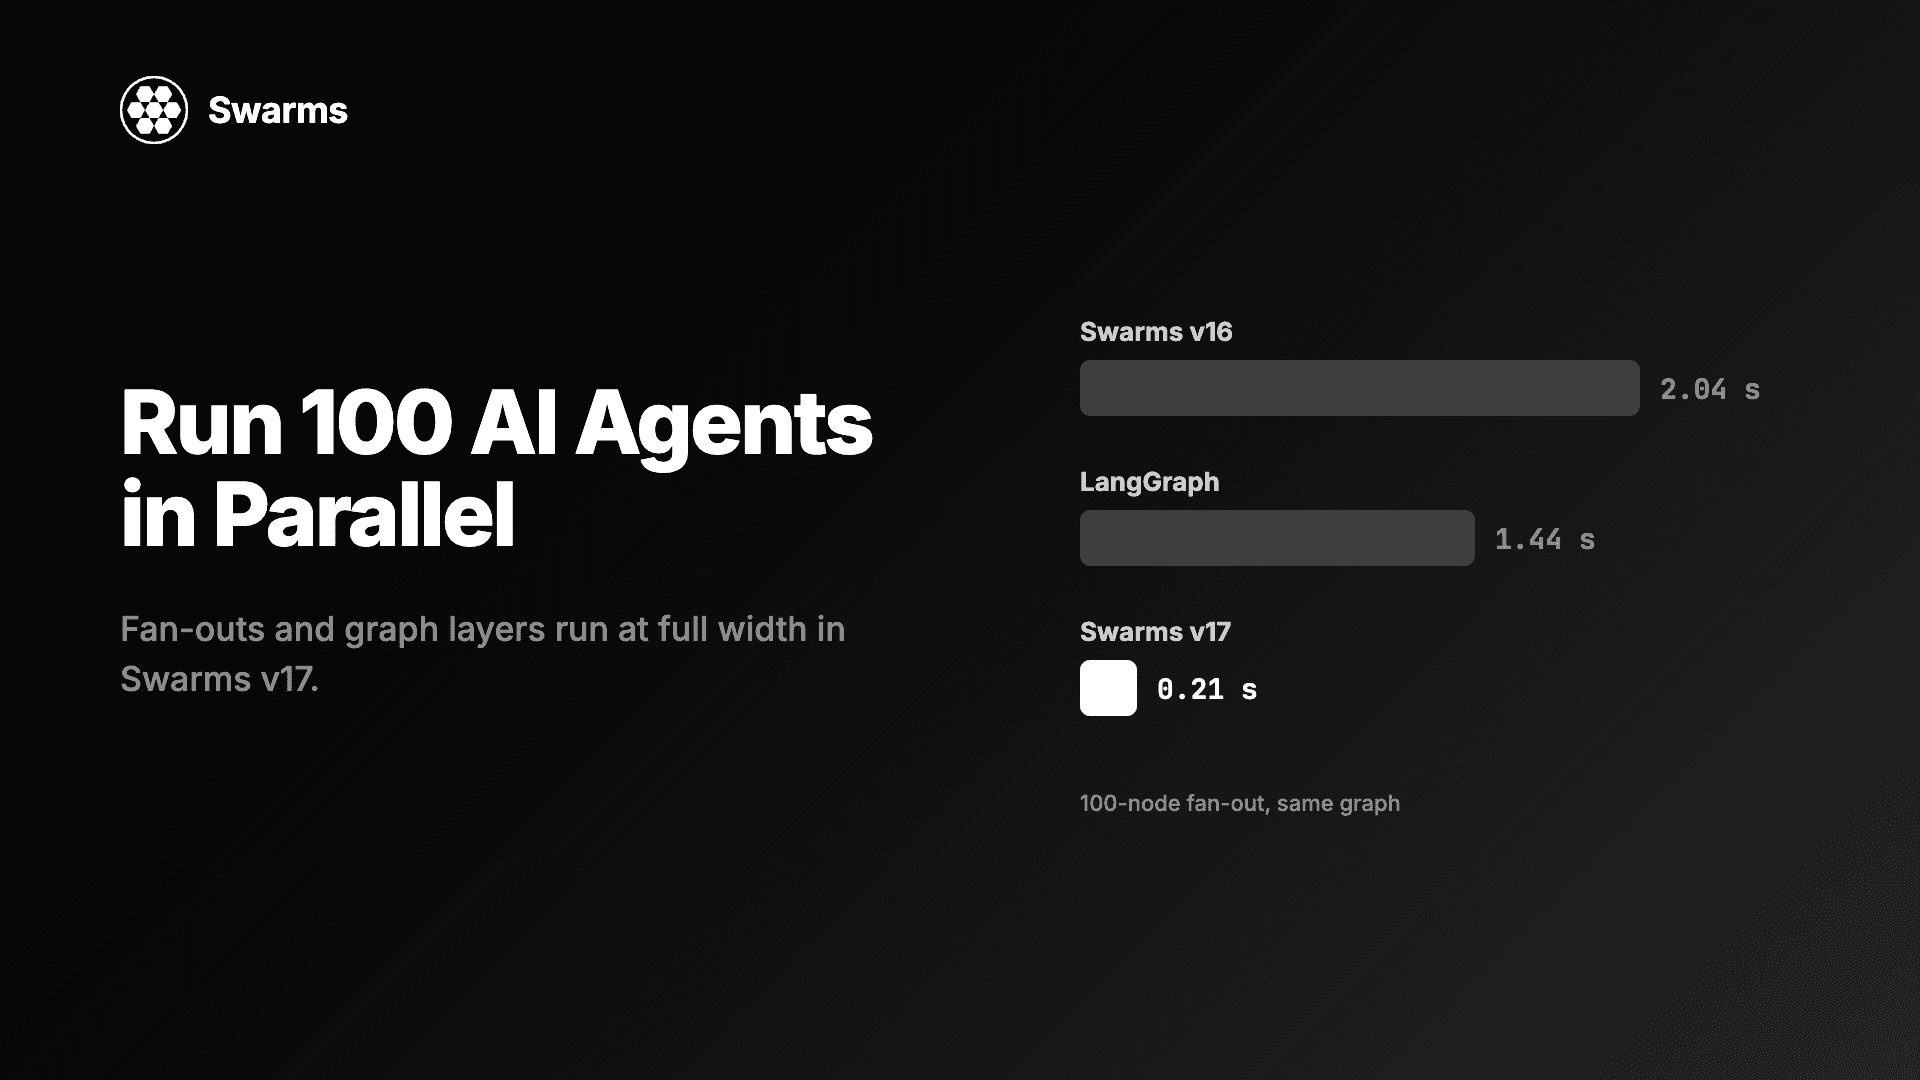
在 Python 中并行运行 AI 智能体:Swarms v17 中 100 个智能体的扇出只需 0.21 秒,此前为 2.04 秒(LangGraph:1.44 秒)。附满宽并发与异步上限的代码。