指南工程
用 SQLite 作为 AI 智能体的共享记忆
用 SQLite 实现 AI 智能体的共享记忆:SqliteChannel 让多个智能体和进程共用一份持久、可查询的对话历史。用 Swarms 存储、共享这份记忆,并对它运行 SQL。
Kye Gomez11 分钟阅读

用 SQLite 实现 AI 智能体的共享记忆:SqliteChannel 让多个智能体和进程共用一份持久、可查询的对话历史。用 Swarms 存储、共享这份记忆,并对它运行 SQL。
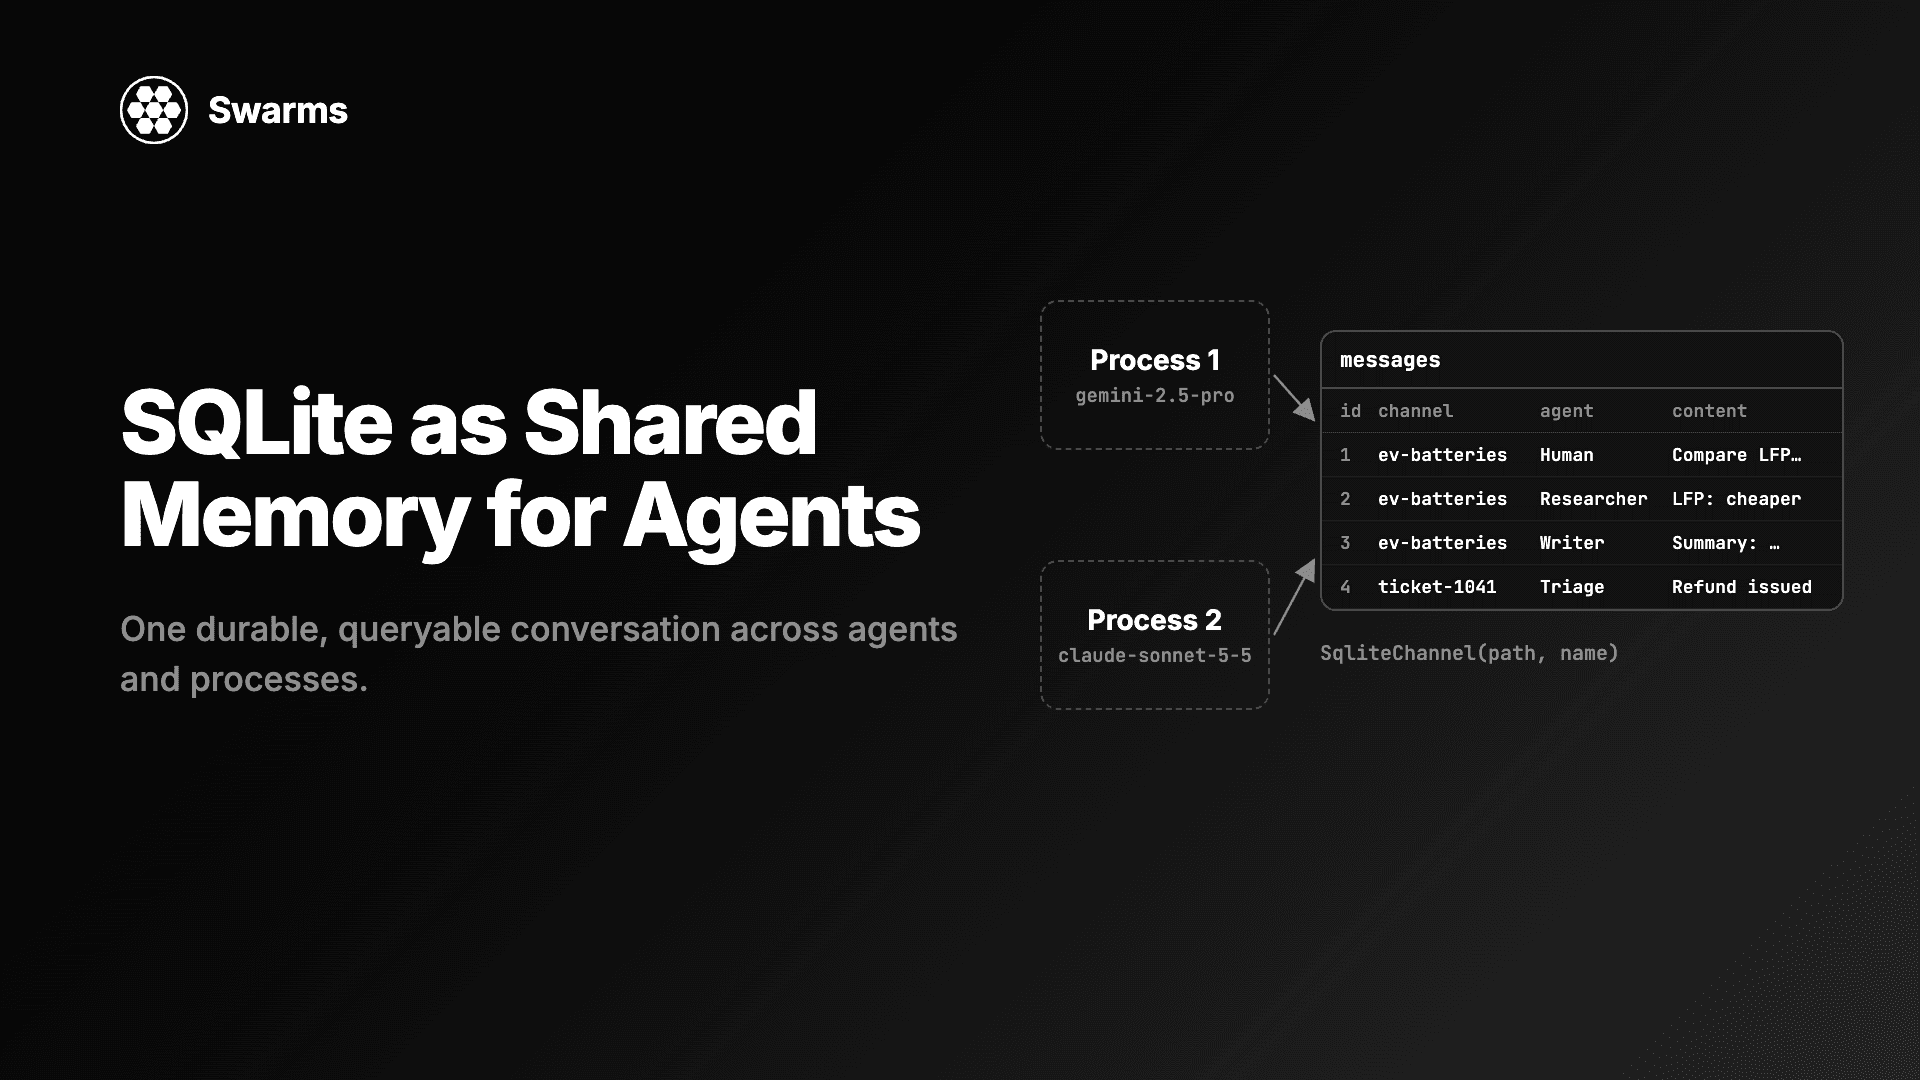
当几个智能体协作处理同一个问题时,它们需要共享记忆:一个地方,每个智能体都能在这里读到其他智能体说过什么,并写下自己要说的话。大多数团队一开始用进程内的列表,后来才发现还希望历史记录能在重启后保留、能在多个工作进程之间共享、出问题时还能查询。一个 SQLite 文件就能同时满足这三点,而且不需要运行任何服务器。
本指南介绍如何借助 Swarms v17「InterLink」 中发布的 SqliteChannel,用 SQLite 作为 AI 智能体的共享记忆。你将把不同服务商上的智能体接到同一段对话,在之后的运行中继续这段对话,在一个文件里保存多段对话,给整个工作流一份记忆,对历史运行 SQL,从多个进程同时写入,并做清理。每个代码块都针对 Swarms 17.0.0 实际运行过,其中模型调用是模拟的,其余一切(SQLite、线程、进程、文件)都真实运行。
"智能体记忆"涵盖好几种不同的东西,先把它们分开会更清楚:
Agent 都在进程内为当前任务保存一段对话。其他智能体看不到它,进程退出后它就消失了。Agent 的 long_term_memory 参数。SqliteChannel 属于第三种。它按顺序逐字保存每条消息,附带发言者名称和时间戳。它不做嵌入,也不做相似度搜索;接入它的智能体会读取整段对话。因此它很适合智能体之间的交接、审计记录和可恢复的运行,而不适合在大型知识库中搜索,那是向量存储的用武之地。
SqliteChannel 是 v17 中的通信频道之一。频道就是任何具备 post(agent_name, content) 和 messages() 的对象,同一套接口还提供了 Markdown 文件、队列、HTTP 服务器和电子邮件线程等实现。如何用 Python 让 AI 智能体相互对话 对它们做了比较。
SqliteChannel(path, name="default") 打开(或创建)位于 path 的数据库文件,name 选择这个频道对应文件中的哪一段对话。打开时,它会把文件切换到 WAL 模式,并在表和索引不存在时创建一张表和一个索引。下面是 Swarms 源码中的原样 SQL:
PRAGMA journal_mode=WAL;

CREATE TABLE IF NOT EXISTS messages (
    id INTEGER PRIMARY KEY,
    channel TEXT NOT NULL,
    agent_name TEXT NOT NULL,
    content TEXT NOT NULL,
    created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX IF NOT EXISTS messages_channel ON messages (channel, id);
文件中的所有对话共用这张表,以 channel 列区分。id 决定顺序,created_at 是 SQLite 的 CURRENT_TIMESTAMP,即 YYYY-MM-DD HH:MM:SS 格式的 UTC 时间。各个方法直接对应这张表:
| 方法 | 作用 |
|---|---|
post(agent_name, content) | 向这段对话插入一行 |
messages() | 返回这段对话的 [{"agent_name", "content"}, ...],从旧到新 |
fetch_messages(agent_name=None, limit=None) | 同样的行,带上 id 和 created_at,可按发言者过滤,也可只取最新的 N 条 |
SqliteChannel.list_conversations(path) | 文件中所有对话的名称,按各自第一条消息到达的顺序排列 |
clear() | 只删除这段对话的行 |
close() | 关闭连接;文件保留所有消息 |
把路径设为 ":memory:" 时,对话只保存在当前进程中,写测试时很方便。
pip install -U swarms示例使用了多个服务商。每个服务商都需要在环境变量中设置密钥(OPENAI_API_KEY、ANTHROPIC_API_KEY、GEMINI_API_KEY、DEEPSEEK_API_KEY、MISTRAL_API_KEY、GROQ_API_KEY),只需为你使用的服务商设置。SQLite 随 Python 一起提供,不需要再安装别的东西。
给两个智能体同一个频道,它们就共享一段对话。这里 Gemini 上的研究员收集事实,Claude 上的写作者把事实整理成摘要:
from swarms import Agent, SqliteChannel

channel = SqliteChannel("agent_memory.db", name="ev-batteries")

researcher = Agent(
    agent_name="Researcher",
    system_prompt="You gather facts and figures. Answer in a short bullet list.",
    model_name="gemini/gemini-2.5-pro",
    max_loops=1,
    output_type="final",
    print_on=False,
    channel=channel,
)
writer = Agent(
    agent_name="Writer",
    system_prompt="Turn the facts in the conversation into a three-sentence summary.",
    model_name="anthropic/claude-sonnet-5-5",
    max_loops=1,
    output_type="final",
    print_on=False,
    channel=channel,
)

task = "Summarize the state of solid-state EV batteries."
researcher.run(task)
print(writer.run(task))

for row in channel.fetch_messages():
    print(row["id"], row["created_at"], row["agent_name"], "|", row["content"][:50])
研究步骤交给 Gemini 2.5 Pro,因为它擅长处理大量原始材料;文字由 Claude Sonnet 5.5 来写。output_type="final" 让 run() 只返回回复本身。
接入频道的智能体遵循三条规则。运行前,它把频道中的消息读作之前的对话轮次。它只发布一次任务,署名为它的 user_name(默认是 "Human"),所以两个智能体拿到同一个任务时只会留下一份。运行成功后,它以自己的 agent_name 发布答案;运行失败则什么都不发布。在一个全新的数据库上,循环会输出三行:
1 2026-11-04 19:25:41 Human | Summarize the state of solid-state EV batteries.
2 2026-11-04 19:25:41 Researcher | ...
3 2026-11-04 19:25:41 Writer | ...
写作者运行时,它的请求中先是研究员的答案,然后是任务。模型看到的是之前消息的文本;agent_name 列是给你和你的查询用的。所以提示词里应该指向"上面的事实"或"上面的摘要",不要按名字点另一个智能体。
文件比进程活得更久。从一个新脚本、一个定时任务或一个重启后的工作进程里,用相同的路径和名称打开它,下一个智能体就会从上一个停下的地方接着做:
from swarms import Agent, SqliteChannel

# A later run, in a new process: same file, same conversation name.
channel = SqliteChannel("agent_memory.db", name="ev-batteries")
print(len(channel.messages()), "messages already in the conversation")

editor = Agent(
    agent_name="Editor",
    system_prompt="You edit drafts for length and clarity.",
    model_name="gpt-5.4",
    max_loops=1,
    output_type="final",
    print_on=False,
    channel=channel,
)

print(editor.run("Cut the summary above to one sentence."))
print(len(channel.messages()), "messages now")
在上一个脚本之后运行,它先输出 3 messages already in the conversation,然后输出 5 messages now(新任务加上编辑的答案)。编辑的请求在它自己的任务之前带上了全部三条早先的消息。
智能体有频道时,频道就是它的记忆。每个请求都由频道中的行加上新任务构成,所以智能体之前运行时留在进程内的历史不会被带进去。这也是一个数据库可以安全地支撑许多段独立对话的原因。
name 选择一段对话,所以一个文件可以为每张客户工单、每个用户会话或每个任务各存一段对话。这里 Groq 上的分诊智能体处理两张工单,每张工单在各自的对话中:
from swarms import Agent, SqliteChannel

DB = "agent_memory.db"
tickets = {
    "ticket-1041": "My March invoice charged me twice.",
    "ticket-1042": "The export button returns a 500 error.",
}

for name, text in tickets.items():
    channel = SqliteChannel(DB, name=name)  # one conversation per ticket, one file
    triage = Agent(
        agent_name="Triage",
        system_prompt="Classify the ticket as billing, bug or other, and say why in one line.",
        model_name="groq/openai/gpt-oss-120b",  # fast and cheap for high-volume triage
        max_loops=1,
        output_type="final",
        print_on=False,
        user_name="Customer",  # the task is posted under this name
        channel=channel,
    )
    triage.run(text)
    channel.close()

print(SqliteChannel.list_conversations(DB))
print(SqliteChannel(DB, name="ticket-1042").messages())
Groq 的 gpt-oss-120b 适合每张进来的工单都要跑一遍的步骤,这种场景下速度和价格比深度更重要。设置 user_name="Customer" 会把工单文本记在这个发言者名下。在前面示例所用的同一个文件中,脚本输出了 ['ev-batteries', 'ticket-1041', 'ticket-1042'],第二张工单的对话有两行,一行来自 Customer,一行来自 Triage。
结构也接受频道。SequentialWorkflow、ConcurrentWorkflow、AgentRearrange、GraphWorkflow、MixtureOfAgents、GroupChat、HierarchicalSwarm、PlannerWorkerSwarm 和 MajorityVoting 都接受 channel=,并把对话记录写入其中。频道归结构所有,结构会解除成员智能体上各自的频道(并给出警告),所以每条消息只写一次:
from swarms import Agent, SequentialWorkflow, SqliteChannel

channel = SqliteChannel("agent_memory.db", name="semiconductor-brief")

researcher = Agent(
    agent_name="Researcher",
    system_prompt="Collect the key facts and figures as a bullet list.",
    model_name="gemini/gemini-2.5-pro",  # long context for source material
    max_loops=1,
    print_on=False,
)
analyst = Agent(
    agent_name="Analyst",
    system_prompt="Interpret the facts above: trends, risks, open questions.",
    model_name="deepseek/deepseek-v4-pro",
    max_loops=1,
    print_on=False,
)
writer = Agent(
    agent_name="Writer",
    system_prompt="Write a one-page brief from the conversation.",
    model_name="anthropic/claude-sonnet-5-5",
    max_loops=1,
    print_on=False,
)

workflow = SequentialWorkflow(
    agents=[researcher, analyst, writer],
    max_loops=1,
    channel=channel,
)
workflow.run("Brief me on the US semiconductor sector.")

for row in channel.fetch_messages():
    print(row["id"], row["agent_name"], len(row["content"]), "chars")

print("Writer's latest message:", channel.fetch_messages(agent_name="Writer", limit=1)[0]["id"])
工作流先以 User 的名义发布任务,然后每个智能体按顺序各写一行:User、Researcher、Analyst、Writer。fetch_messages(agent_name="Writer", limit=1) 可以不写 SQL 就拿到某个发言者最新的一条消息。DeepSeek V4 Pro 作为分析师放在中间,这个模型能力强,价格比写作者用的模型低。
和单个智能体一样,非空的频道会让运行接着往下走:明天把一个新工作流指向 name="semiconductor-brief",它就会从这份记录开始。
历史记录就是一张普通的表,所以任何 SQLite 客户端都能查询它:Python 的 sqlite3、sqlite3 命令行、BI 工具或 pandas。做分析时以只读方式打开,这样报表脚本永远无法改动智能体记住的内容:
import sqlite3

# Read-only connection: analytics can never modify agent memory.
conn = sqlite3.connect("file:agent_memory.db?mode=ro", uri=True)

print("Messages per speaker, per conversation:")
for row in conn.execute(
    """
    SELECT channel, agent_name, COUNT(*) AS n
    FROM messages
    GROUP BY channel, agent_name
    ORDER BY channel, n DESC
    """
):
    print(" ", row)

print("Every message that mentions a 500 error:")
for row in conn.execute(
    """
    SELECT channel, id, agent_name, substr(content, 1, 60)
    FROM messages
    WHERE content LIKE ?
    ORDER BY id
    """,
    ("%500 error%",),
):
    print(" ", row)

print("Latest message in each conversation:")
for row in conn.execute(
    """
    SELECT m.channel, m.agent_name, m.created_at
    FROM messages AS m
    JOIN (SELECT channel, MAX(id) AS id FROM messages GROUP BY channel) AS last
      ON m.id = last.id
    ORDER BY m.id
    """
):
    print(" ", row)

print("Conversations active in the last 24 hours (created_at is UTC):")
for row in conn.execute(
    """
    SELECT channel, COUNT(*)
    FROM messages
    WHERE created_at >= datetime('now', '-1 day')
    GROUP BY channel
    """
):
    print(" ", row)

conn.close()
在前面示例建立的数据库上,第一个查询输出了 ('ev-batteries', 'Human', 2)、('semiconductor-brief', 'Analyst', 1) 和 ('ticket-1042', 'Customer', 1) 这样的行,搜索在 ticket-1042 中找到了客户的消息。(channel, id) 索引覆盖了频道自身按对话进行的查找。如果要在大量历史上做大量搜索,可以在 messages 旁边自己加索引或建一张 FTS5 表;频道只读写它自己的那张表。
SqliteChannel 对线程和进程都是安全的。在一个进程内,连接上的一把锁让发布操作串行执行,所以扇出步骤可以从许多线程同时发布(v17 的拉取请求测试了 8 个线程发布 40 条消息)。在进程之间,SQLite 自身的文件锁让写入者串行执行,WAL 模式让读取者在写入进行时照常读取。
进程间的规则很简单:每个进程打开自己的 SqliteChannel。连接不能传给另一个进程,所以要传的是路径和名称。这里一个由四个工作进程组成的进程池在四个服务商上回复八张工单,每个工作进程还会写入同一段共享的 ops-log 对话:
import os
import sqlite3
from concurrent.futures import ProcessPoolExecutor

from swarms import Agent, SqliteChannel

DB = "support.db"
MODELS = [
    "gpt-5.4-mini",
    "anthropic/claude-haiku-5-5",
    "mistral/mistral-large-latest",
    "groq/openai/gpt-oss-120b",
]


def handle_ticket(job):
    ticket_id, text, model = job
    # Each process opens its own connection; never pass a channel between processes.
    channel = SqliteChannel(DB, name=ticket_id)
    ops_log = SqliteChannel(DB, name="ops-log")  # one conversation every process writes to
    try:
        agent = Agent(
            agent_name="Support-Agent",
            system_prompt="Draft a short, friendly first reply to the customer.",
            model_name=model,
            max_loops=1,
            output_type="final",
            print_on=False,
            user_name="Customer",
            channel=channel,
        )
        agent.run(text)
        ops_log.post("Support-Agent", f"{ticket_id} answered by {model} in pid {os.getpid()}")
    finally:
        channel.close()
        ops_log.close()
    return ticket_id


if __name__ == "__main__":
    # Open the file once up front so the table and WAL mode exist before workers start.
    SqliteChannel(DB, name="ops-log").close()

    jobs = [
        (f"ticket-{2000 + i}", f"Customer message number {i}", MODELS[i % len(MODELS)])
        for i in range(8)
    ]
    with ProcessPoolExecutor(max_workers=4) as pool:
        finished = list(pool.map(handle_ticket, jobs))

    conn = sqlite3.connect(DB)
    print("tickets answered:", len(finished))
    print("conversations:", len(SqliteChannel.list_conversations(DB)))
    print(
        "processes that wrote to ops-log:",
        conn.execute(
            "SELECT COUNT(DISTINCT substr(content, instr(content, 'pid '))) "
            "FROM messages WHERE channel = 'ops-log'"
        ).fetchone()[0],
    )
    print(
        "rows per ticket:",
        conn.execute(
            "SELECT MIN(n), MAX(n) FROM (SELECT COUNT(*) AS n FROM messages "
            "WHERE channel LIKE 'ticket-%' GROUP BY channel)"
        ).fetchone(),
    )
conn.close()四个小模型分布在四个服务商上,所以某个账号被限流或宕机,最多影响四分之一的工单。if __name__ == "__main__": 保护是必需的,因为在 macOS 和 Windows 上,工作进程启动时会导入你的脚本。我们在 macOS 上用 Python 默认的 spawn 启动方式运行了它:
tickets answered: 8
conversations: 9
processes that wrote to ops-log: 4
rows per ticket: (2, 2)
四个独立的进程向一个文件写入了 24 行(每张工单两行,加上 ops-log 中的八行),一行都没有丢。
SqliteChannel 使用 Python 默认的 5 秒忙等待超时,所以一次发布最多等待这么久来获取锁,超时则抛出 sqlite3.OperationalError: database is locked。和模型调用相比,智能体的发布又小又少,所以这很少成为问题,但如果有脚本在同一个文件上持有很长的写事务,就可能触发。HttpChannel;如何让多台机器上的 AI 智能体共享一段对话 一文有完整演示。agent_memory.db-wal 和 agent_memory.db-shm 会出现在数据库旁边。运行过程中做备份,请用 SQLite 的备份 API 或 VACUUM INTO,不要只复制 .db 文件。智能体记忆随每次运行增长,而接入频道的智能体每个请求都会发送整段对话,所以长对话会消耗 token。把对话的范围划窄(每张工单、每个任务一段),完成后就删掉。clear() 删除一段对话;更大范围的清理就是对同一张表执行普通 SQL:
import json
import sqlite3

from swarms import SqliteChannel

DB = "agent_memory.db"

# Archive one finished conversation to JSON Lines, then remove it from the database.
ticket = SqliteChannel(DB, name="ticket-1041")
with open("ticket-1041.jsonl", "w") as f:
    for row in ticket.fetch_messages():
        f.write(json.dumps(row) + "\n")
ticket.clear()  # deletes this conversation's rows only
ticket.close()

# Age-based retention across every conversation is plain SQL on the same table.
conn = sqlite3.connect(DB)
with conn:
    expired = conn.execute(
        "DELETE FROM messages WHERE created_at < datetime('now', '-30 days')"
    ).rowcount
conn.execute("VACUUM")  # give the freed pages back to the filesystem
conn.close()

print("expired rows deleted:", expired)
print(SqliteChannel.list_conversations(DB))运行之后,ticket-1041 从 list_conversations 中消失了,它的两行保存在 ticket-1041.jsonl 中。为了检验按时间删除,我们插入了一行日期为 45 天前的记录,再次运行脚本:它输出 expired rows deleted: 1。请在没有智能体写入时运行 VACUUM,因为它需要独占数据库。
fallback_models 和 SwarmRouter(fallback_swarms=...)。clear() 成为任务收尾的自然一步。close() 释放连接;消息仍保留在文件中。它是一个多个智能体都能读写的存储,每个智能体都可以在其他智能体的工作基础上继续。使用 SqliteChannel 时,它是 SQLite 表中一段有序的对话(发言者、文本、时间戳),智能体每次运行前都会把它读作之前的对话轮次。
不是。它逐字保存消息并按顺序返回,没有嵌入,也没有相似度搜索。共享对话历史和交接用它,在大型文档集上做检索则用向量存储(Agent 的 long_term_memory 参数)。
可以。每个进程在同一路径上打开自己的 SqliteChannel,由 SQLite 让写入串行执行。在一个进程内,频道的锁让你可以安全地从许多线程发布。请把文件放在本地磁盘上。
每条消息都是 messages 表中的一行,包含 id、channel、agent_name、content 和 created_at。用任何 SQLite 客户端打开文件,最好以只读方式(file:agent_memory.db?mode=ro),再按 channel 过滤出某一段对话。
对频道调用 clear() 删除这段对话,或者执行 DELETE FROM messages WHERE created_at < datetime('now', '-30 days'),对所有对话按时间做保留,然后运行 VACUUM 回收空间。
pip install -U swarmsSwarms v17「InterLink」更新日志 介绍了每一种通信频道以及接受频道的结构,可运行的频道示例(包括 SQLite)位于 Swarms 仓库 的 examples/channel_examples/ 目录中。API 参考在 docs.swarms.world。
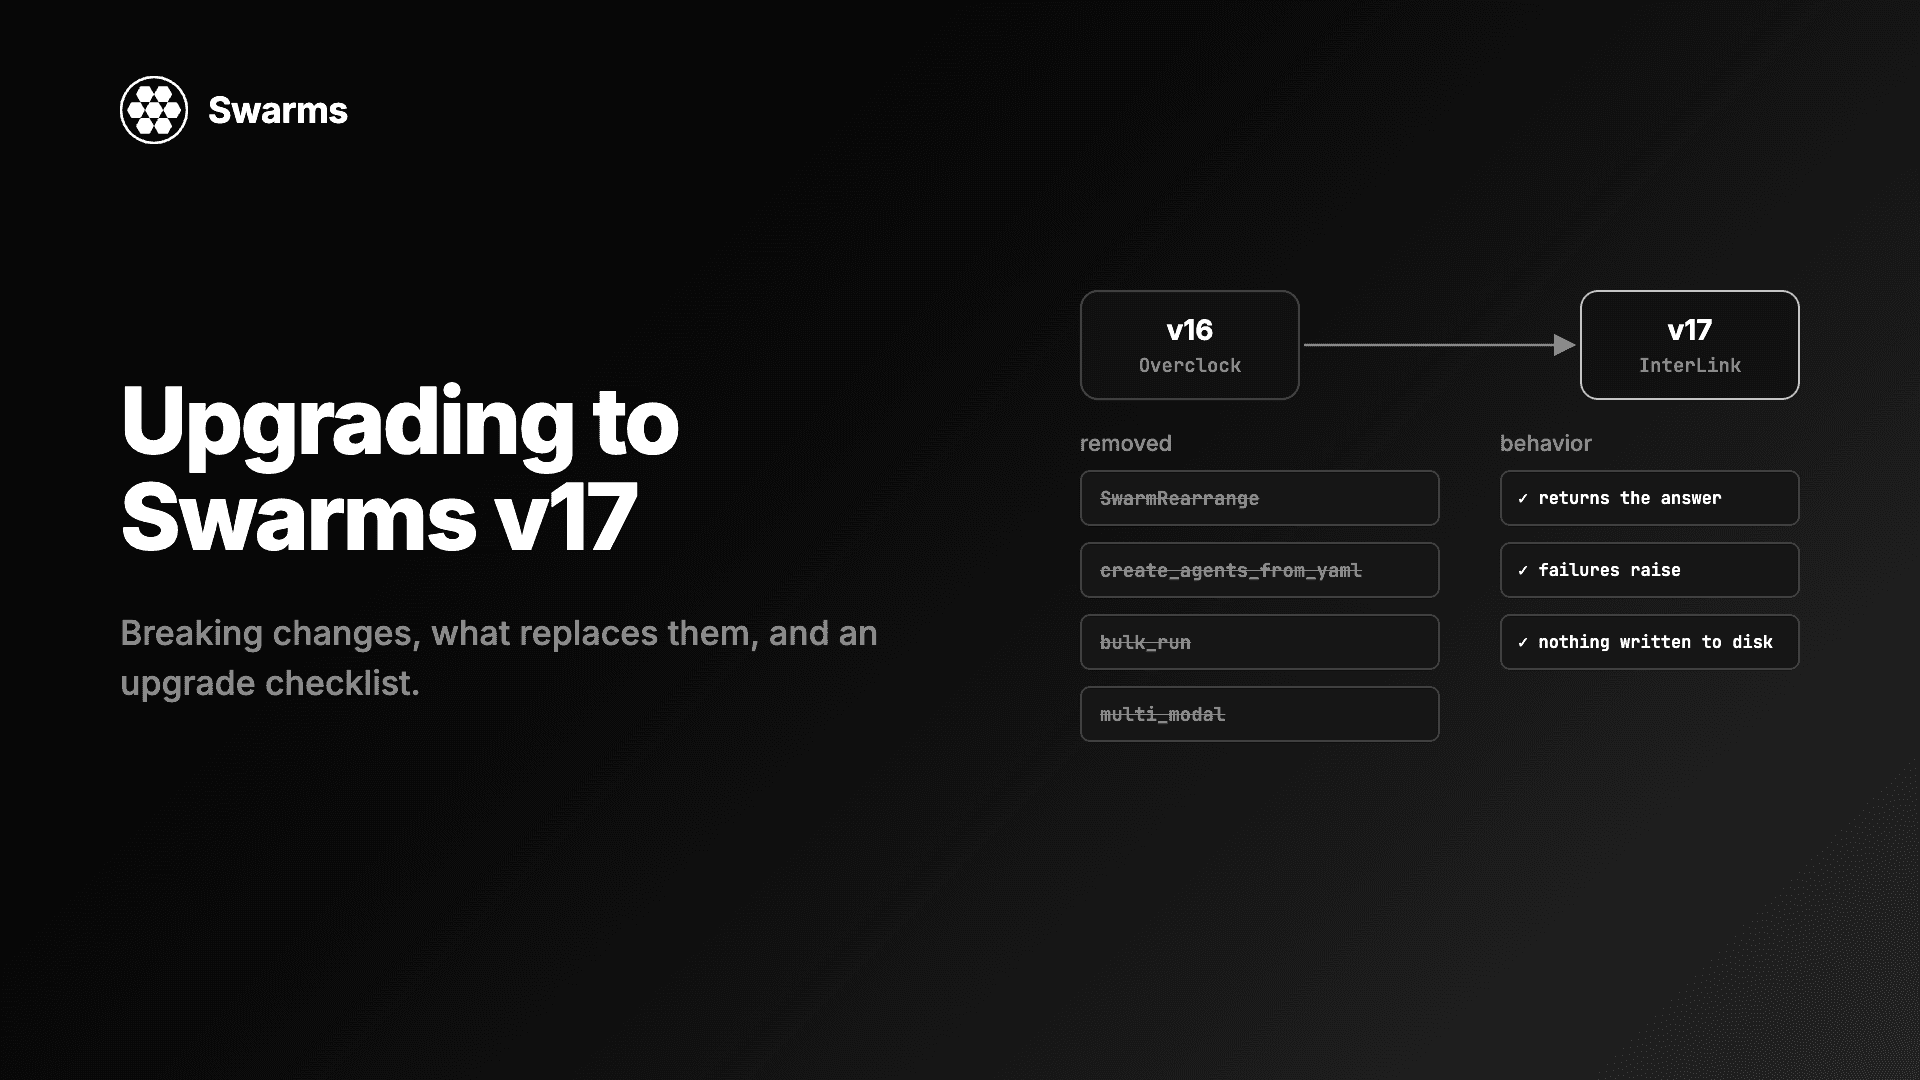
Swarms v17 升级与迁移指南:InterLink 中移除的每个类和参数、应该改用什么、变更的默认行为,以及一份升级检查清单。
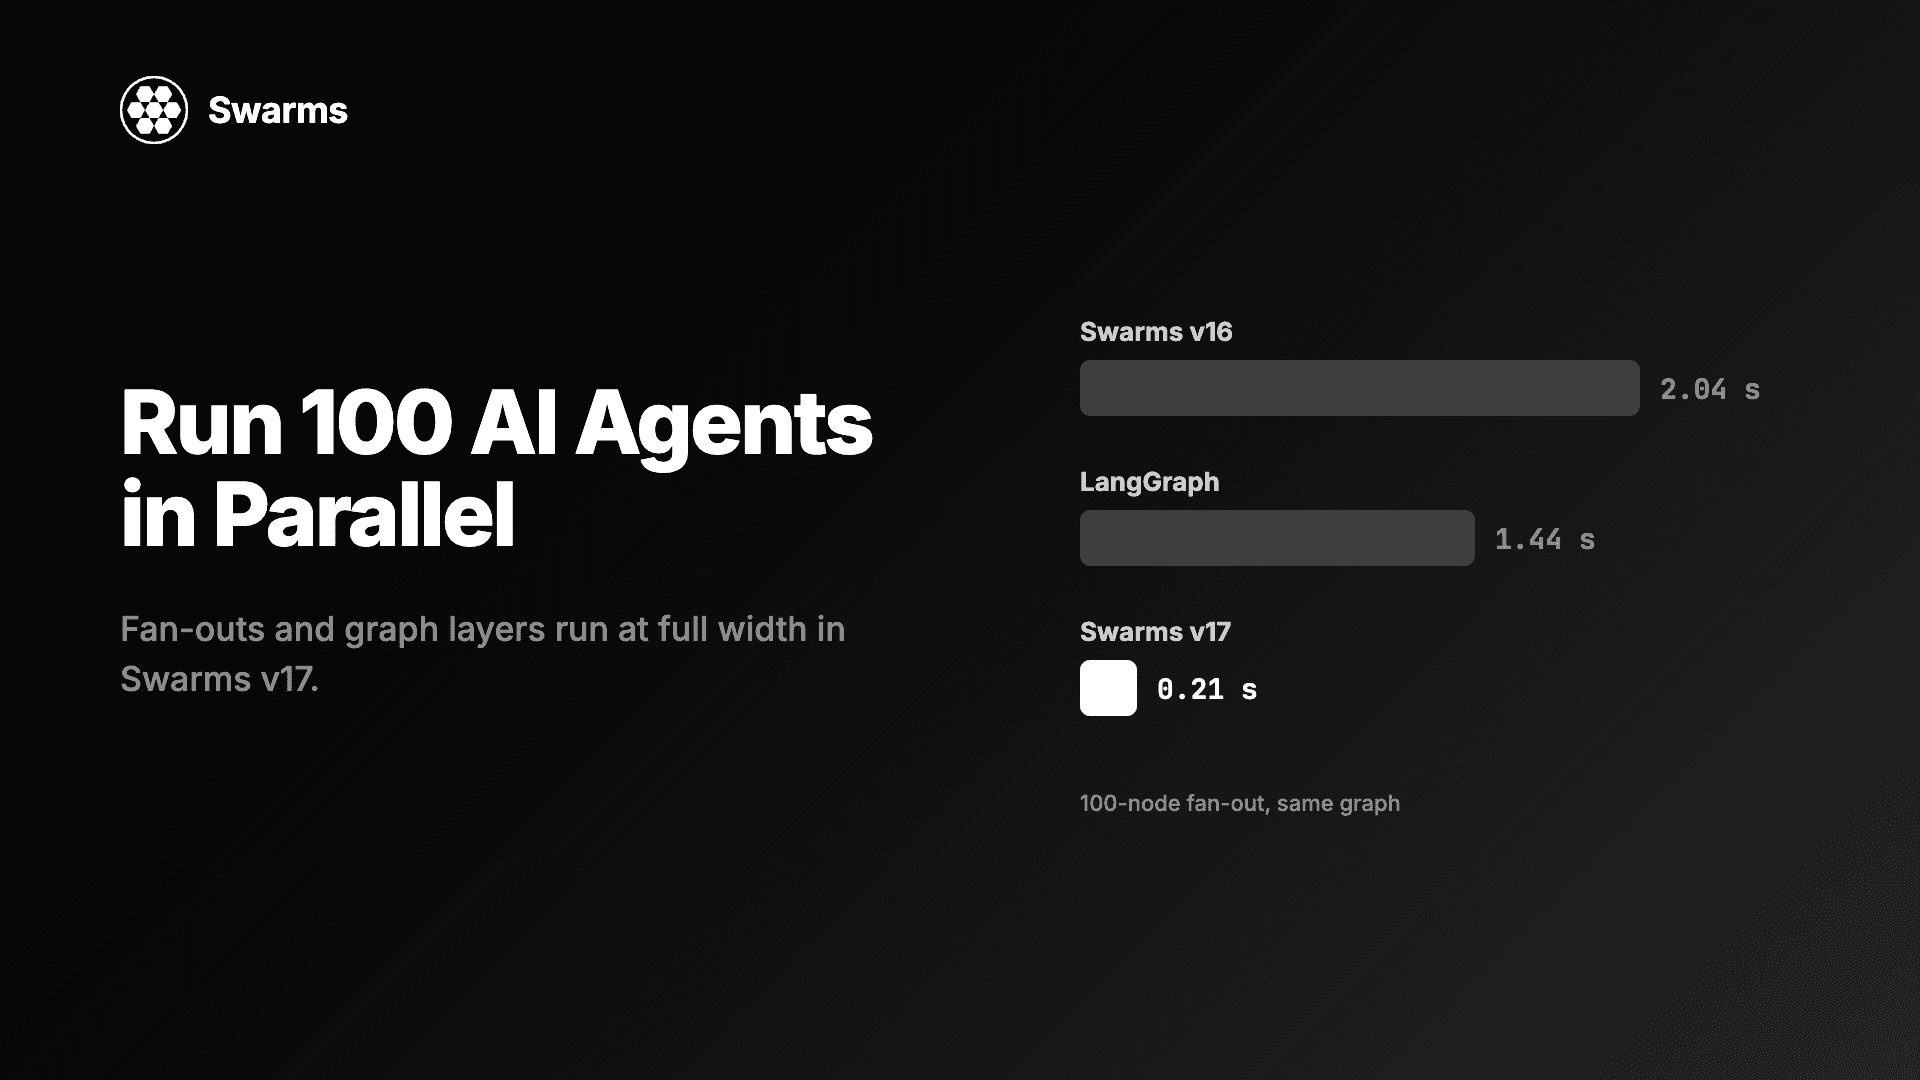
在 Python 中并行运行 AI 智能体:Swarms v17 中 100 个智能体的扇出只需 0.21 秒,此前为 2.04 秒(LangGraph:1.44 秒)。附满宽并发与异步上限的代码。
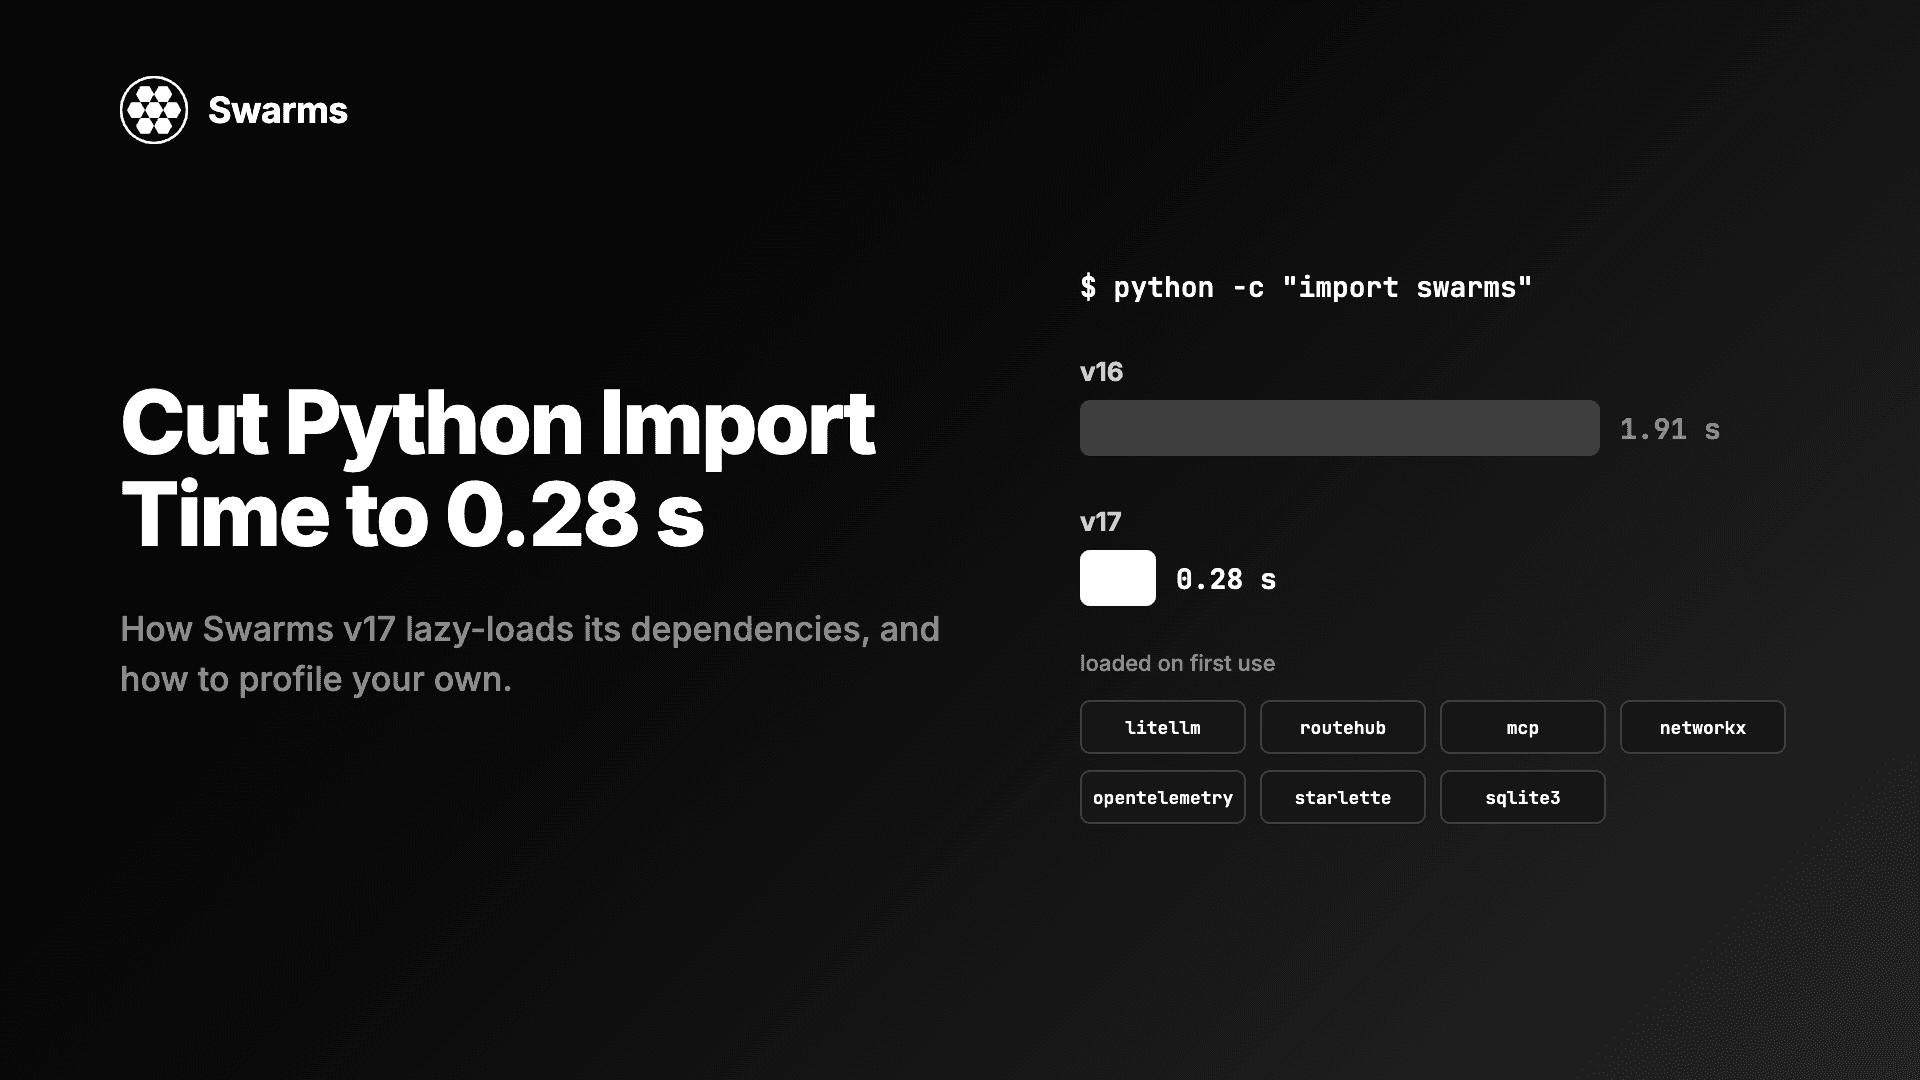
降低 Python 导入时间与智能体冷启动:借助懒加载、导入时不写磁盘,import swarms 从 1.91 秒降到 0.28 秒。附剖析自己代码导入耗时的方法。