指南工程
为什么你的 Python 智能体框架要花 2 秒导入(以及我们如何把它降到 0.28 秒)
降低 Python 导入时间与智能体冷启动:借助懒加载、导入时不写磁盘,import swarms 从 1.91 秒降到 0.28 秒。附剖析自己代码导入耗时的方法。
Kye Gomez14 分钟阅读

降低 Python 导入时间与智能体冷启动:借助懒加载、导入时不写磁盘,import swarms 从 1.91 秒降到 0.28 秒。附剖析自己代码导入耗时的方法。
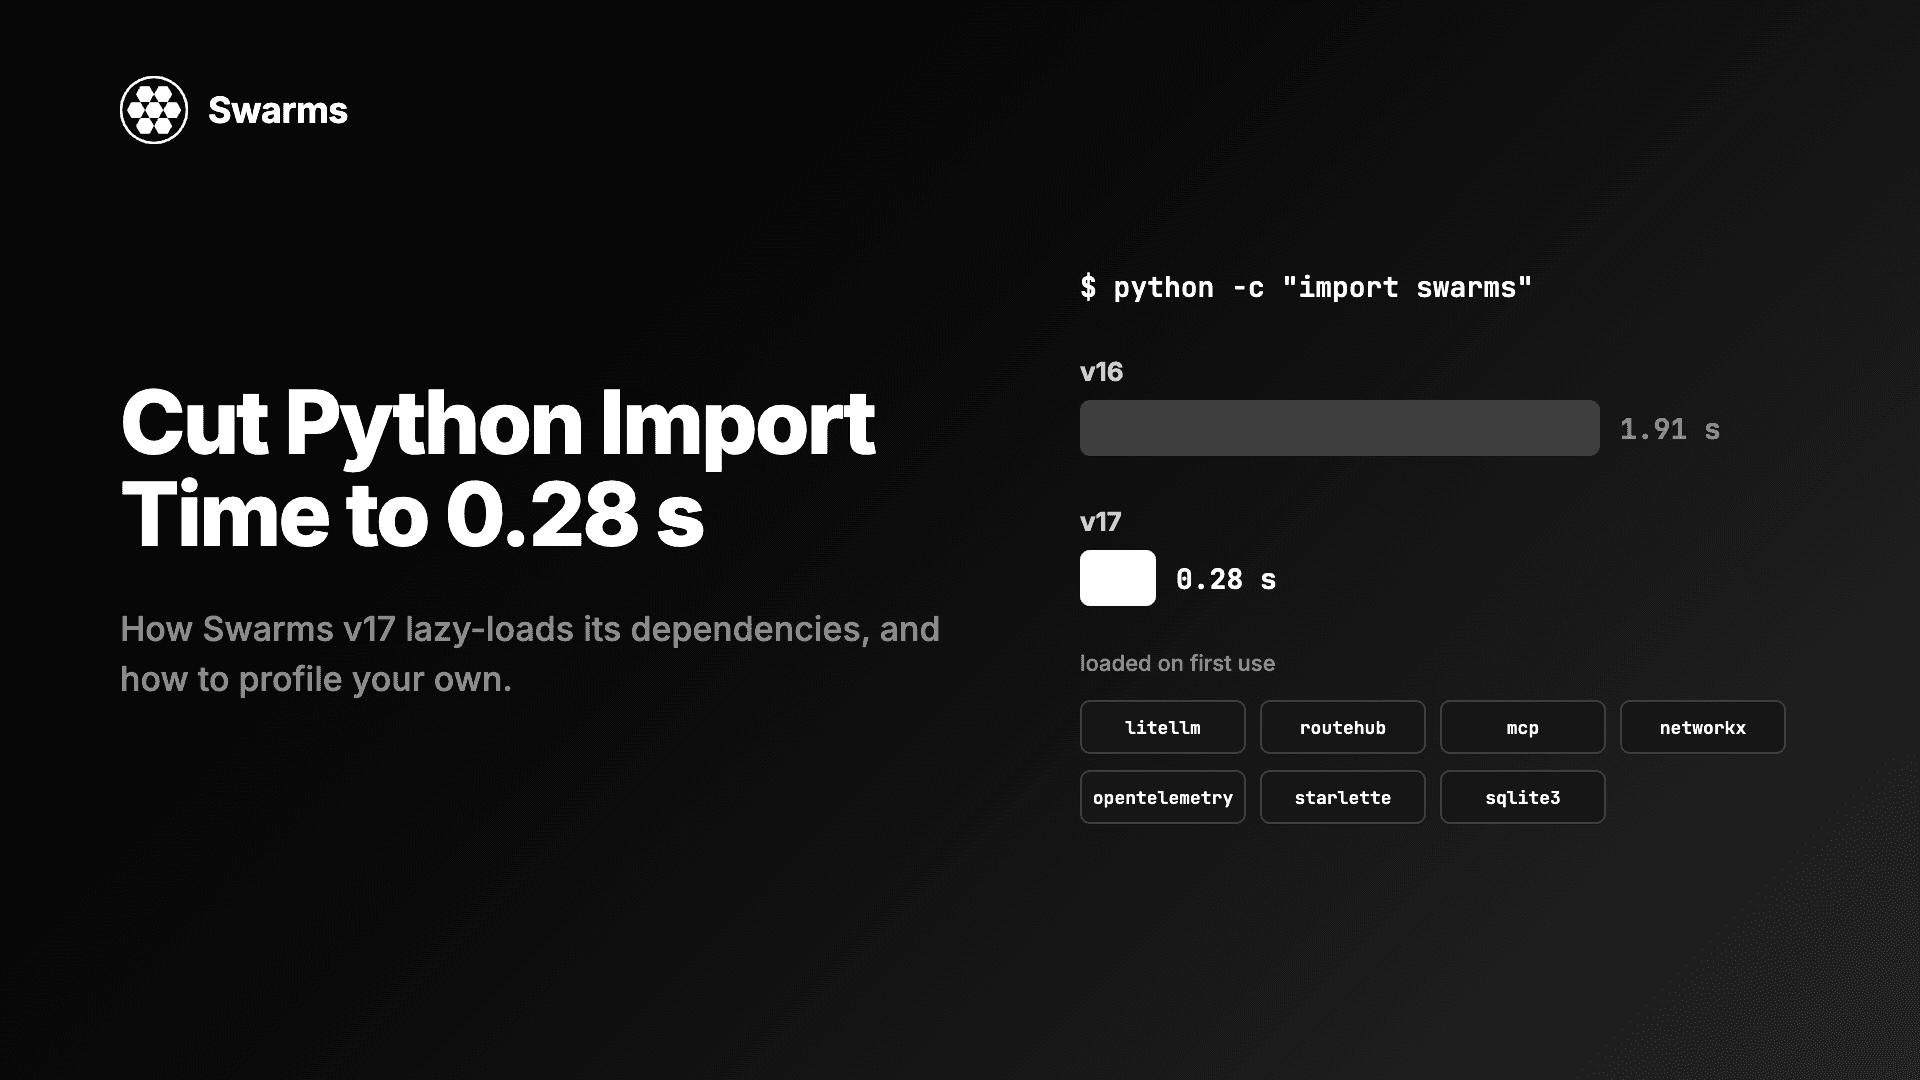
在 Swarms v16 中,import swarms 需要 1.91 秒。在 Swarms v17 "InterLink" 中,它只需要 0.28 秒。框架能做的事情一样没少,区别在于它什么时候为依赖付出代价:litellm、RouteHub、mcp、networkx、OpenTelemetry、starlette 和 sqlite3 现在都在第一次被用到时才加载,import swarms 不再向磁盘写任何东西,而构建一个设置了上下限的 Agent 也不会打开任何网络连接。
这篇指南写给想要降低 Python 导入时间的开发者(无论是智能体框架还是自己的包),也写给正在和 Serverless 函数或命令行工具中缓慢的智能体冷启动作斗争的人。内容包括:导入时间为什么重要,如何正确测量,让 Swarms 从 1.91 秒降到 0.28 秒的具体改动,以及把这些模式写成可以直接复制进你自己包里的小段可运行代码。
两秒听起来不多,直到你算一算进程启动的频率。
swarms --help 不应该花两秒。任何在文件顶部导入了智能体框架的命令行工具都一样。智能体框架尤其容易出现这个问题,因为它要和所有东西集成。你在模块顶部加的每一个模型供应商 SDK、协议客户端、图计算库和导出器,都会变成每个用户在导入时都要付出的成本,包括那些从来不用这个功能的用户。
先测量,再改动。需要回答三个问题:导入花了多长时间,哪些模块该为此负责,以及导入时还做了什么。
在一个长期运行的解释器里给导入计时会产生误导,因为 Python 会把模块缓存在 sys.modules 中,第二次 import 不花任何时间。正确的做法是每次采样都启动一个新的解释器,并取中位数。下面这个脚本可以对任意模块这样做:
"""Time an import in fresh Python processes and report the median."""
import statistics
import subprocess
import sys

MODULE = "swarms"  # change to any module you want to measure
RUNS = 9

# Runs inside each child process: time only the import statement.
CHILD = (
    "import time\n"
    "t0 = time.perf_counter()\n"
    f"import {MODULE}\n"
    "print(time.perf_counter() - t0)\n"
)


def import_seconds() -> float:
    """Start a new interpreter, import MODULE, return the seconds it took."""
    result = subprocess.run(
        [sys.executable, "-c", CHILD],
        capture_output=True,
        text=True,
        check=True,
    )
    return float(result.stdout.strip().splitlines()[-1])


import_seconds()  # warm-up: the first run pays for cold disk caches and .pyc writes
samples = sorted(import_seconds() for _ in range(RUNS))

print(f"import {MODULE}: median {statistics.median(samples):.3f} s over {RUNS} fresh processes")
print(f"min {samples[0]:.3f} s, max {samples[-1]:.3f} s")
有两个细节很重要。热身运行的结果会被丢弃,因为安装后的第一次导入还要编译 .pyc 文件,并从磁盘读取冷数据。报告的是中位数,因为一次偶然的慢采样(比如另一个进程抢占了 CPU)不应该影响结果。不同机器之间、繁忙笔记本上的不同次运行之间,数字都会有差异;比较版本时,要在同一台机器上前后连续测量。
下文引用的 Swarms 数字来自 v17 更新日志,它报告的是在同一台机器(macOS,Python 3.12)上九个全新进程的中位数,遥测保持默认开启,v16 与 v17 对比。
python -X importtime 找出慢的导入知道了总耗时之后,再找出时间花在哪里。CPython 自带一个导入剖析器:
python -X importtime -c "import swarms" 2> importtime.log

# the 20 largest cumulative times (microseconds, second column)
sort -t'|' -k2 -n importtime.log | tail -20每一行有三列:模块自身的耗时(self),包含它导入的所有内容在内的耗时(cumulative),以及模块名,模块名按它在导入树中的深度缩进。从 cumulative 这一列开始读:找到最大的几项,然后顺着缩进往下追,直到遇到一个 self 耗时很大的模块,或者它的子项是一个你没预料到会被加载的第三方库。如果无法修改命令行,设置 PYTHONPROFILEIMPORTTIME=1 和 -X importtime 效果相同。
输出很快就会变得很长(一个框架的导入可能有上千行)。tuna 可以把日志变成一棵可以在浏览器里点击展开的交互式树:
pip install tuna
tuna importtime.log
一个模块在每个进程中只加载一次,所以它的成本会记在第一个导入它的模块头上。如果 requests 出现在你的日志模块下面,那份成本属于 requests;日志模块只是第一个需要它的模块而已。
计时能告诉你有多慢,却不能告诉你导入做了什么。下面的脚本在一个空的临时目录里,用全新进程执行 import swarms 并构建一个 Agent,然后报告加载了哪些重量级库,以及是否出现了新文件:
"""Check what `import swarms` and building an Agent load and write."""
import json
import os
import subprocess
import sys
import tempfile

HEAVY = [
    "litellm", "routehub", "mcp", "networkx", "rustworkx", "graphviz",
    "opentelemetry", "starlette", "anyio", "toml", "sqlite3",
]

CHILD = r"""
import json, sys, time

t0 = time.perf_counter()
import swarms
t1 = time.perf_counter()

from swarms import Agent

agent = Agent(
    agent_name="Cold-Start-Probe",
    model_name="gpt-5.4-mini",
    max_loops=1,
    context_length=200_000,  # set both limits, so the model catalog is never consulted
    max_tokens=4_096,
)
t2 = time.perf_counter()

heavy = json.loads(sys.argv[1])
loaded = sorted(h for h in heavy if any(m == h or m.startswith(h + ".") for m in sys.modules))
print(json.dumps({"import_s": t1 - t0, "agent_s": t2 - t1, "loaded": loaded}))
"""

with tempfile.TemporaryDirectory() as workdir:
    env = {k: v for k, v in os.environ.items() if k != "WORKSPACE_DIR"}
    result = subprocess.run(
        [sys.executable, "-c", CHILD, json.dumps(HEAVY)],
        cwd=workdir, env=env, capture_output=True, text=True, check=True,
    )
    report = json.loads(result.stdout.strip().splitlines()[-1])
    written = sorted(os.listdir(workdir))

print(f"import swarms:   {report['import_s']:.3f} s")
print(f"Agent(...):      {report['agent_s'] * 1000:.1f} ms")
print(f"heavy libraries: {report['loaded'] or 'none'}")
print(f"files written:   {written or 'none'}")
在 Swarms 17.0.0 上,设置 SWARMS_TELEMETRY_ON=False 并安装了 RouteHub 时,重量级库那一行显示 none,文件那一行也显示 none。有三种情况会改变这个结果,而且每一种都在预期之内:
SWARMS_LLM_BACKEND=litellm 时,构建智能体会导入 litellm,因为 litellm 把 drop_params 这类设置保存为模块级全局变量,必须在模块上设置。RouteHub 在每次调用时接收这些设置,所以可以等到第一次请求再加载。context_length 和 max_tokens,智能体会在后端的模型目录里查找自己的模型来补全这两个值,这会在构建时导入后端。这个探测脚本只把 gpt-5.4-mini 当作模型名使用,不会向 OpenAI 发送任何内容,所以不需要 API 密钥也能运行。
import swarms 从 1.91 秒降到 0.28 秒以下是 v17 更新日志 中的核心数字(九个全新进程的中位数,同一台机器):
| v16 | v17 | |
|---|---|---|
import swarms | 1.91 秒 | 0.28 秒 |
import swarms + Agent(...),已安装 RouteHub | 2.09 秒 | 0.51 秒 |
import swarms + Agent(...),强制使用 litellm | 2.30 秒 | 1.83 秒 |
import swarms 加载的重量级库 | litellm、mcp、networkx、rustworkx、graphviz、OpenTelemetry SDK、starlette、anyio、toml、sqlite3 | 一个都没有 |
import swarms 写入的文件 | agent_workspace/ 和 agent_workspace/error.txt | 无 |
这不是某一个改动的功劳。十一个 PR 各自把一项成本移出了导入路径。其中最大的几项:
| 移出导入路径的内容 | PR 中测得的节省 |
|---|---|
| litellm 或 RouteHub,改为在第一次模型调用时导入 | litellm 约 800 毫秒 |
mcp,改为在使用服务器时导入 | 约 400 毫秒 |
| networkx、rustworkx、graphviz,通过一个懒加载模块 | 47.8 毫秒 → 1.0 毫秒 |
| 遥测关闭时的 OpenTelemetry API | 15 个模块 → 0 |
anyio 和 starlette,只在 MCPDeployer 提供服务时加载 | 4.8 毫秒 → 0.5 毫秒 |
启动线程池和工作区 mkdir | 导入时不写磁盘 |
这些改动背后的技术是通用的。下面逐一介绍,并指出它们在 Swarms 源码中的位置。
单项最大的成本来自 LLM 客户端库。在 v17 中,包内所有对 litellm 的导入都经过同一个模块 swarms/utils/llm_backend.py。它在导入时决定使用哪个后端(如果安装了 RouteHub 就用 RouteHub,否则用 litellm,或者按 SWARMS_LLM_BACKEND 的指定),判断方式是 importlib.util.find_spec,它只检查包是否存在,不会真正导入。库本身在 backend_module() 中导入,也就是第一次请求补全的时候。
Swarms 其他部分需要从客户端拿到的东西,比如 get_model_info 或各种异常类,都由一个模块级 __getattr__(PEP 562)提供:第一次访问 llm_backend.AuthenticationError 时导入后端、取出属性并缓存到模块的全局变量中,之后的查找就是普通的字典读取。调用方照常写 llm_backend.get_model_info(...),完全感觉不到导入被推迟了。
这也是为什么 litellm 的导入成本对很多用户来说不再重要。推迟它的那个 PR 测得仅 litellm 一项就节省了约 800 毫秒(我们在 LiteLLM 为什么慢? 中分析过这些时间花在了哪里)。推迟导入意味着,一个导入了 Swarms 但还没有发起模型调用的程序不必为它付出代价;而 pip install "swarms[fast]" 会换上 RouteHub,等第一次调用真正到来时,它的导入成本也更低。
GraphWorkflow 支持 networkx、rustworkx 和 graphviz,但大多数导入 Swarms 的程序从来不会构建图。swarms/structs/graph_workflow.py 把每个库名绑定到一个小代理对象上,代理的 __getattr__ 会在任何属性第一次被读取时导入真正的模块:
nx = _LazyModule("networkx")
rx = _LazyModule("rustworkx") if RUSTWORKX_AVAILABLE else None
文件其余部分照旧写 nx.DiGraph()。可用性标志使用 find_spec,所以检查 rustworkx 是否安装只需要一次目录查找,不需要导入。PR 测得这条路径从 47.8 毫秒降到了 1.0 毫秒。
TYPE_CHECKINGmcp 包的导入大约需要 0.4 秒。swarms/tools/mcp_manager.py 在打开连接的函数内部导入它,并通过 if TYPE_CHECKING: 代码块让类型检查器仍然能看到类型名,这个条件在运行时为 False。同样的做法也适用于只有少数代码路径需要的小模块:SqliteChannel 在构造函数中导入 sqlite3,所以一个从不打开 SQLite 频道的程序永远不会加载它。
函数级导入在第一次调用之后几乎没有成本(只是在 sys.modules 里做一次字典查找),唯一的代价是文件看起来没那么整齐。
Swarms 的遥测默认开启。设置 SWARMS_TELEMETRY_ON=False 后,v17 完全不会导入任何 OpenTelemetry 模块,trace_run 会原样返回你的方法,所以 Agent.run 没有任何追踪包装。遥测开启时,SDK 和导出器在第一次追踪时加载,而不是在导入时加载。这个开关在导入 Swarms 时读取,所以要在程序启动前通过环境变量(或 .env 文件)设置。
Agent() 时不联网v16 在 import swarms 时会顺带在当前目录创建一个 agent_workspace/ 目录和一个 error.txt 文件。v17 只是把默认的 WORKSPACE_DIR 路径记录到环境变量中,目录在第一次真正写入时才创建。工作流默认不再自动保存,日志文件也只在设置 SWARMS_LOG_FILES=True 时才写入。这一点对只读文件系统最重要,而很多 Serverless 平台除了 /tmp 之外给你的正是只读文件系统。
构建智能体也不再去访问网络。在 RouteHub 上,Agent() 过去会下载 OpenRouter 的模型目录,只为了打印 "may not be supported" 之类的警告:联网时要 162 毫秒,在无法访问它的主机上要 10 秒。现在这些检查只在设置 SWARMS_STRICT_MODEL_CHECK=true 时运行,而一个设置了 context_length 和 max_tokens 的智能体只需 13 毫秒就能构建完成,并且不打开任何连接。
同样的三种模式适用于任何包。下面的例子用 sqlite3 代替一个昂贵的依赖,这样不需要安装任何东西就能运行;你可以把它换成 pandas、torch、networkx 或某个模型供应商的 SDK。
__getattr__ 实现懒加载的公开名称假设你的包导出一个轻量的 Client 和一个较重的 ReportStore。用户会写 from fastpkg import ReportStore,你希望这种写法继续可用,但 import fastpkg 不应该加载 store 的依赖。把包组织成这样:
fastpkg/
    __init__.py
    client.py
    store.py
demo.py
fastpkg/__init__.py 立即导入轻量部分,在第一次访问时才解析重量部分:
"""fastpkg: cheap to import, loads its heavy parts on first use (PEP 562)."""
import importlib
from typing import TYPE_CHECKING, Any

from fastpkg.client import Client  # light: imported eagerly

# Public name -> the submodule that defines it.
_LAZY = {
    "ReportStore": "fastpkg.store",
}

__all__ = ["Client", *_LAZY]

if TYPE_CHECKING:  # type checkers and IDEs still see the real classes
    from fastpkg.store import ReportStore


def __getattr__(name: str) -> Any:
    """Called only when `name` is not already a module global."""
    module_name = _LAZY.get(name)
    if module_name is None:
        raise AttributeError(f"module {__name__!r} has no attribute {name!r}")
    value = getattr(importlib.import_module(module_name), name)
    globals()[name] = value  # cache it: later lookups never reach __getattr__
    return value


def __dir__() -> list:
    return sorted(set(globals()) | set(__all__))
fastpkg/client.py 和 fastpkg/store.py:
# fastpkg/client.py
class Client:
    def __init__(self, name: str):
self.name = name# fastpkg/store.py
import sqlite3 # stands in for any expensive dependency
class ReportStore:
def __init__(self, path: str = ":memory:"):
self.conn = sqlite3.connect(path)
self.conn.execute("CREATE TABLE IF NOT EXISTS reports (body TEXT)")
def add(self, body: str) -> None:
self.conn.execute("INSERT INTO reports VALUES (?)", (body,))
def count(self) -> int:
return self.conn.execute("SELECT COUNT(*) FROM reports").fetchone()[0]以及 demo.py,在包含 fastpkg/ 的目录中运行:
import sys

import fastpkg

print("after import:      store loaded =", "fastpkg.store" in sys.modules)

client = fastpkg.Client("cli")
print("after Client:      store loaded =", "fastpkg.store" in sys.modules)

store = fastpkg.ReportStore()  # first access runs __getattr__ and imports the module
store.add("nightly run ok")
print("after ReportStore: store loaded =", "fastpkg.store" in sys.modules, "| rows:", store.count())

from fastpkg import ReportStore  # `from` imports go through __getattr__ too
print(ReportStore is fastpkg.ReportStore)
python demo.py 会依次输出 False、False,然后是 True | rows: 1,最后是 True。有几个细节能让这个模式在真实的包中站得住:
AttributeError。 hasattr、getattr(module, name, default) 以及导入系统都依赖这一点。globals() 中。 第一次访问之后,这个名称就是普通的全局变量,__getattr__ 不会再为它被调用。TYPE_CHECKING 导入。 没有它们,编辑器和类型检查器就会丢失所有懒加载名称的类型。from fastpkg import *。 星号导入会请求 __all__ 中的每一个名称,从而一次性触发所有懒加载导入。这是正确的行为,也是在包内部避免对自己使用星号导入的一个理由。Swarms 自己也用这个模式处理 swarms.__version__:只有当有人读取版本号时,才去读取已安装发行包的元数据。
如果昂贵的是一个在某个文件中到处使用的第三方模块,用代理对象比把每个导入都挪进函数里改动更小。它和 Swarms graph_workflow.py 中的 _LazyModule 是同一个形状:
"""A module-level stand-in that imports the real module on first attribute access."""
import importlib
import sys
from typing import Any


class LazyModule:
    def __init__(self, name: str):
        self._name = name
        self._module = None

    def __getattr__(self, attr: str) -> Any:
        if self._module is None:
            self._module = importlib.import_module(self._name)
        return getattr(self._module, attr)


sqlite3 = LazyModule("sqlite3")  # swap in networkx, pandas, torch, ...


def count_rows() -> int:
    conn = sqlite3.connect(":memory:")  # the real import happens here, once
    conn.execute("CREATE TABLE t (x INTEGER)")
    conn.executemany("INSERT INTO t VALUES (?)", [(1,), (2,), (3,)])
    return conn.execute("SELECT COUNT(*) FROM t").fetchone()[0]


print("before first use:", "sqlite3" in sys.modules)
print("rows:", count_rows())
print("after first use: ", "sqlite3" in sys.modules)
它会输出 False、rows: 3、True。代理只拦截属性访问,所以 isinstance(x, sqlite3.Connection) 可以正常工作(读取属性会触发导入),但把代理对象本身传给需要真正模块对象的地方就不行了。标准库中还有 importlib.util.LazyLoader,它会创建一个真正的模块对象,在第一次访问属性时才执行;当你确实需要一个 ModuleType 时,它很合适。
导入时间的退化往往悄无声息:某个工具模块顶部新加一行 import pandas,所有用户都要为它买单。一个在全新进程中执行导入并检查 sys.modules 的测试,能在引入问题的那个 Pull Request 上就把它拦下来:
"""test_import_budget.py: fail CI when an import-time regression lands."""
import json
import subprocess
import sys

PACKAGE = "swarms"
MUST_STAY_LAZY = ["litellm", "routehub", "mcp", "networkx", "starlette"]


def modules_loaded_by_import() -> set:
    code = f"import json, sys; import {PACKAGE}; print(json.dumps(sorted(sys.modules)))"
    out = subprocess.run([sys.executable, "-c", code], capture_output=True, text=True, check=True)
    return set(json.loads(out.stdout))


def test_heavy_dependencies_stay_lazy():
    loaded = modules_loaded_by_import()
    eager = [name for name in MUST_STAY_LAZY if name in loaded]
    assert not eager, f"import {PACKAGE} now loads {eager}"


if __name__ == "__main__":
    test_heavy_dependencies_stay_lazy()
    print("ok: none of", MUST_STAY_LAZY, "load at import")
用 pytest test_import_budget.py 运行,或者直接 python test_import_budget.py。在 CI 中,检查模块名比设定一个挂钟时间阈值更稳定,后者在共享的 CI 机器上很容易出现偶发失败。把 PACKAGE 和列表改成你自己项目的即可。
导入只是冷启动的第一部分。对一个智能体来说,完整路径是:启动解释器、导入框架、构建智能体、发起第一次模型调用。Swarms v17 缩短了中间两步,另外几个习惯能让其余部分也保持简短。
"""A serverless-style handler: import once per container, one fresh Agent per request."""
import json
import time

from swarms import Agent  # module scope: paid once per cold start


def build_agent() -> Agent:
    return Agent(
        agent_name="Ticket-Triage",
        model_name="anthropic/claude-haiku-5-5",
        system_prompt=(
            "Classify the support ticket as billing, bug or how-to. "
            "Reply with the label only."
        ),
        max_loops=1,
        context_length=100_000,  # limits you set yourself: no model catalog lookup at build time
        max_tokens=256,
        output_type="final",     # return the reply, not the conversation
        print_on=False,          # no console panels in a function log
    )


def handler(event, context=None):
    started = time.perf_counter()
    agent = build_agent()  # cheap in v17, and no history leaks between requests
    label = agent.run(event["ticket"])
    return {
        "statusCode": 200,
        "body": json.dumps({
            "label": label,
            "agent_build_and_run_ms": round((time.perf_counter() - started) * 1000, 1),
        }),
    }


if __name__ == "__main__":
    for ticket in ["I was charged twice this month.", "The export button does nothing."]:
        print(handler({"ticket": ticket}))
工单分类是一个短小、高频的任务,所以小而快的模型(Claude Haiku 5.5)很合适。它需要设置 ANTHROPIC_API_KEY;其他供应商分别使用 OPENAI_API_KEY、GEMINI_API_KEY 等。在生产环境中运行时需要注意:
agent.reset()。 Agent 会在多次 run() 调用之间把对话保存在 short_memory 中,所以一个被所有请求复用的模块级智能体,会把之前的工单和每个新工单一起发送出去。既然设置了 context_length 和 max_tokens 的构建过程不会打开任何连接,每个请求新建一个智能体就是最简单的解决办法。output_type="final"。 默认输出类型返回第一个输入之后的对话;"final" 返回智能体的回复,这正是处理函数应该返回的内容。swarms[fast]。 模型调用改由 RouteHub 发起,而不是 litellm。在更新日志针对本地 OpenAI 兼容服务器的基准测试中,从冷启动到第一个回答的时间从 litellm 的约 1,140 毫秒降到 RouteHub 的约 580 毫秒,峰值内存从约 210 MB 降到 100 MB。内存更低,也意味着你可以选择更小(更便宜)的函数规格。迁移现有 litellm 代码的方法见 如何从 LiteLLM 迁移到 RouteHub。SWARMS_TELEMETRY_ON=False 会把 OpenTelemetry 从进程中彻底移除。如果你需要追踪数据就保持开启;它在退出时的刷新最多等待一秒,所以一个无法访问的收集器不会让函数长时间挂起。WORKSPACE_DIR 指向 /tmp。 按 v17 的默认设置什么都不会写入,所以只读文件系统没有问题。运行 python -X importtime -c "import yourpackage" 2> importtime.log,查看每个模块的自身耗时和累计耗时,再用 tuna 打开日志获得树状视图。如果需要一个可信的单一数字,就像本文第一个脚本那样,在几个全新子进程中给导入计时并取中位数。
通常是因为包顶部附近的某个模块在模块作用域导入了一个大型第三方库,而大多数程序根本用不到它。常见的有模型供应商 SDK、数据处理库、协议客户端和遥测导出器。导入时的副作用(创建目录、启动线程、网络检查)也会增加耗时。-X importtime 会告诉你是哪条导入链造成的。
__getattr__?PEP 562(Python 3.7)允许模块定义 __getattr__(name),当某个属性在模块全局变量中找不到时,Python 会调用它。各种包用它在第一次访问时才解析重量级的公开名称,这样 import package 依然很快,而 from package import HeavyThing 也照常可用。同时定义 __dir__,让懒加载的名称仍然出现在 dir() 和自动补全中。
import swarms 有多快?0.28 秒,v16 是 1.91 秒(在一台 macOS 机器上、Python 3.12、遥测开启,九个全新进程的中位数)。安装 RouteHub 后,导入并构建一个 Agent 需要 0.51 秒。在你的硬件上绝对数字会不同;比较版本时请在同一台机器上进行。
第一次调用要承担导入客户端库的成本,也就是过去在导入时支付的那部分。到第一个回答的总时间并不会更差,而那些根本不会走到模型调用的程序(打印帮助的命令行工具、测试、等待队列的 Worker)则完全省掉了这部分成本。安装 swarms[fast] 能让这第一次导入便宜很多。
pip install -U swarms

# RouteHub for model calls and rustworkx for graphs
pip install -U "swarms[fast]"
然后在你自己的环境中运行本文的计时脚本,并用导入探测脚本检查你自己的包。如果你正在升级现有项目,请先阅读 升级到 Swarms v17:破坏性变更与迁移指南,因为 v17 还修改了一些默认设置。
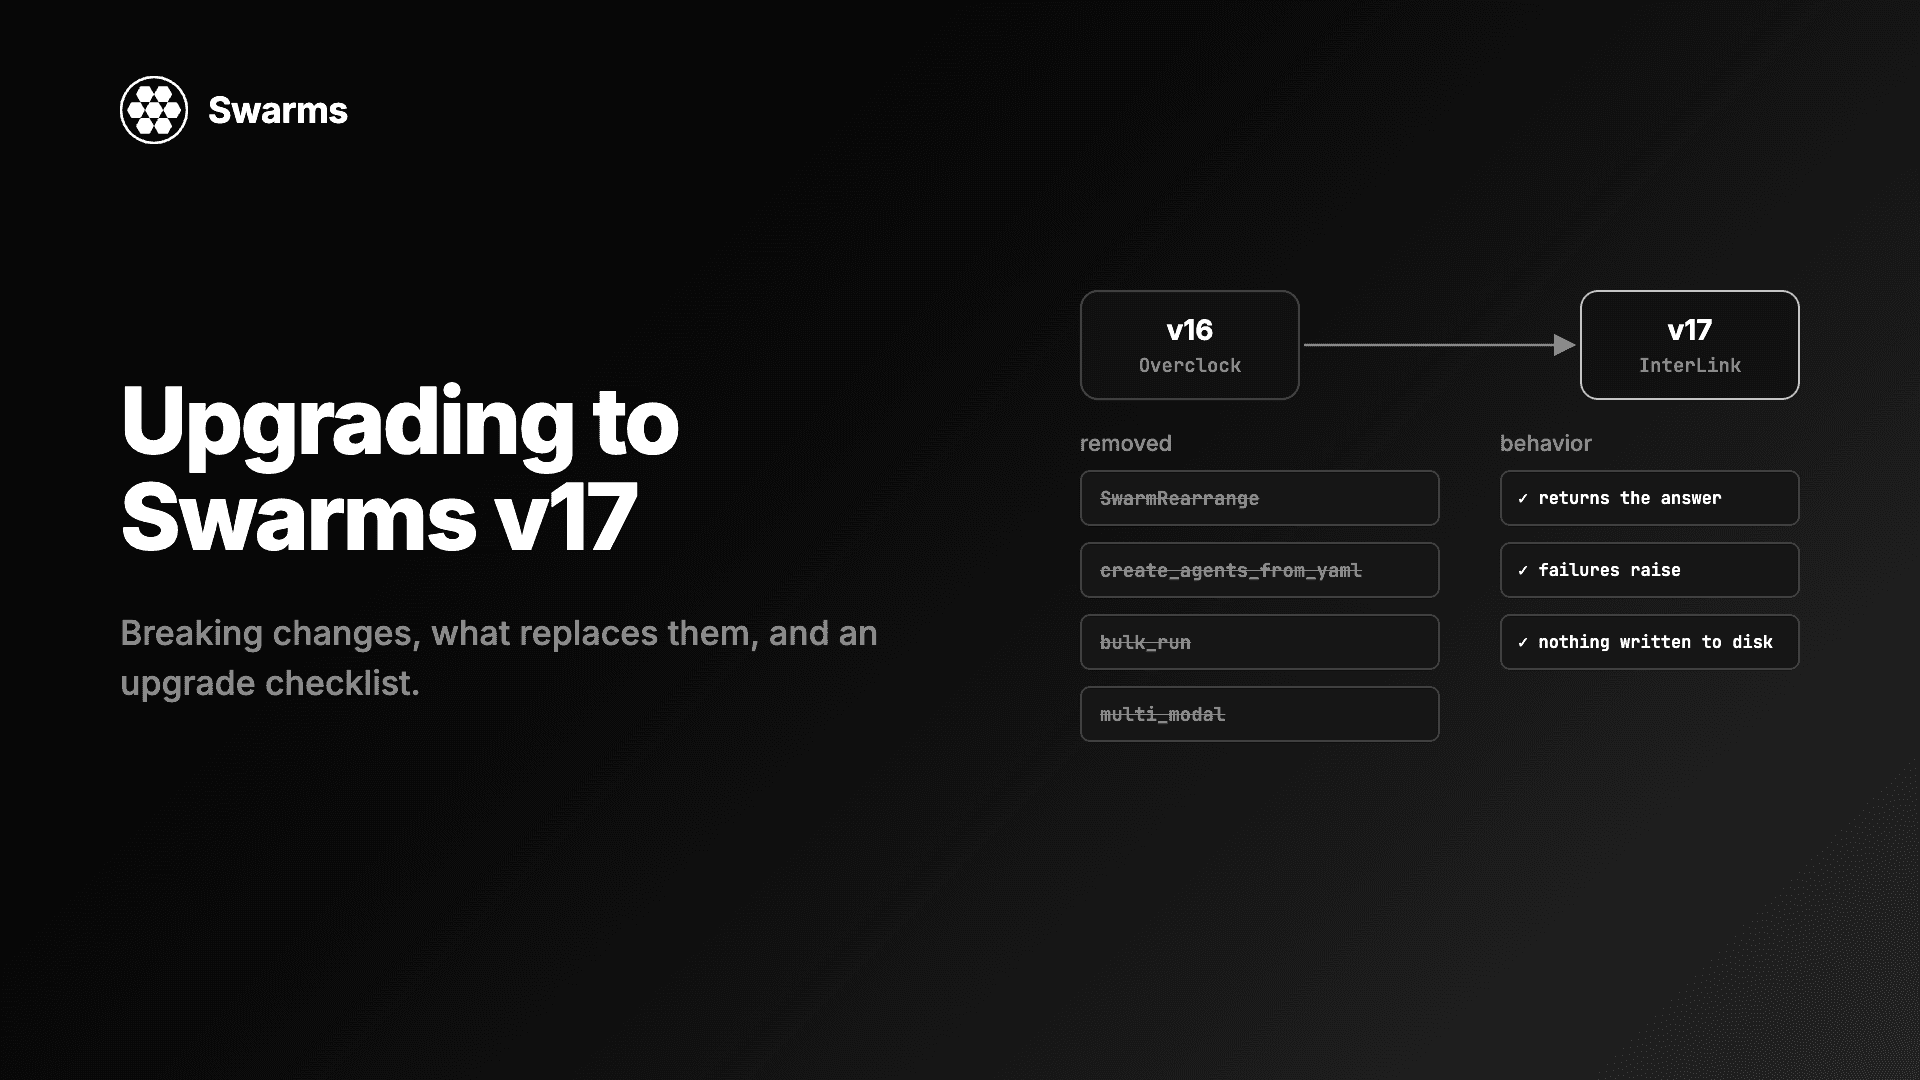
Swarms v17 升级与迁移指南:InterLink 中移除的每个类和参数、应该改用什么、变更的默认行为,以及一份升级检查清单。
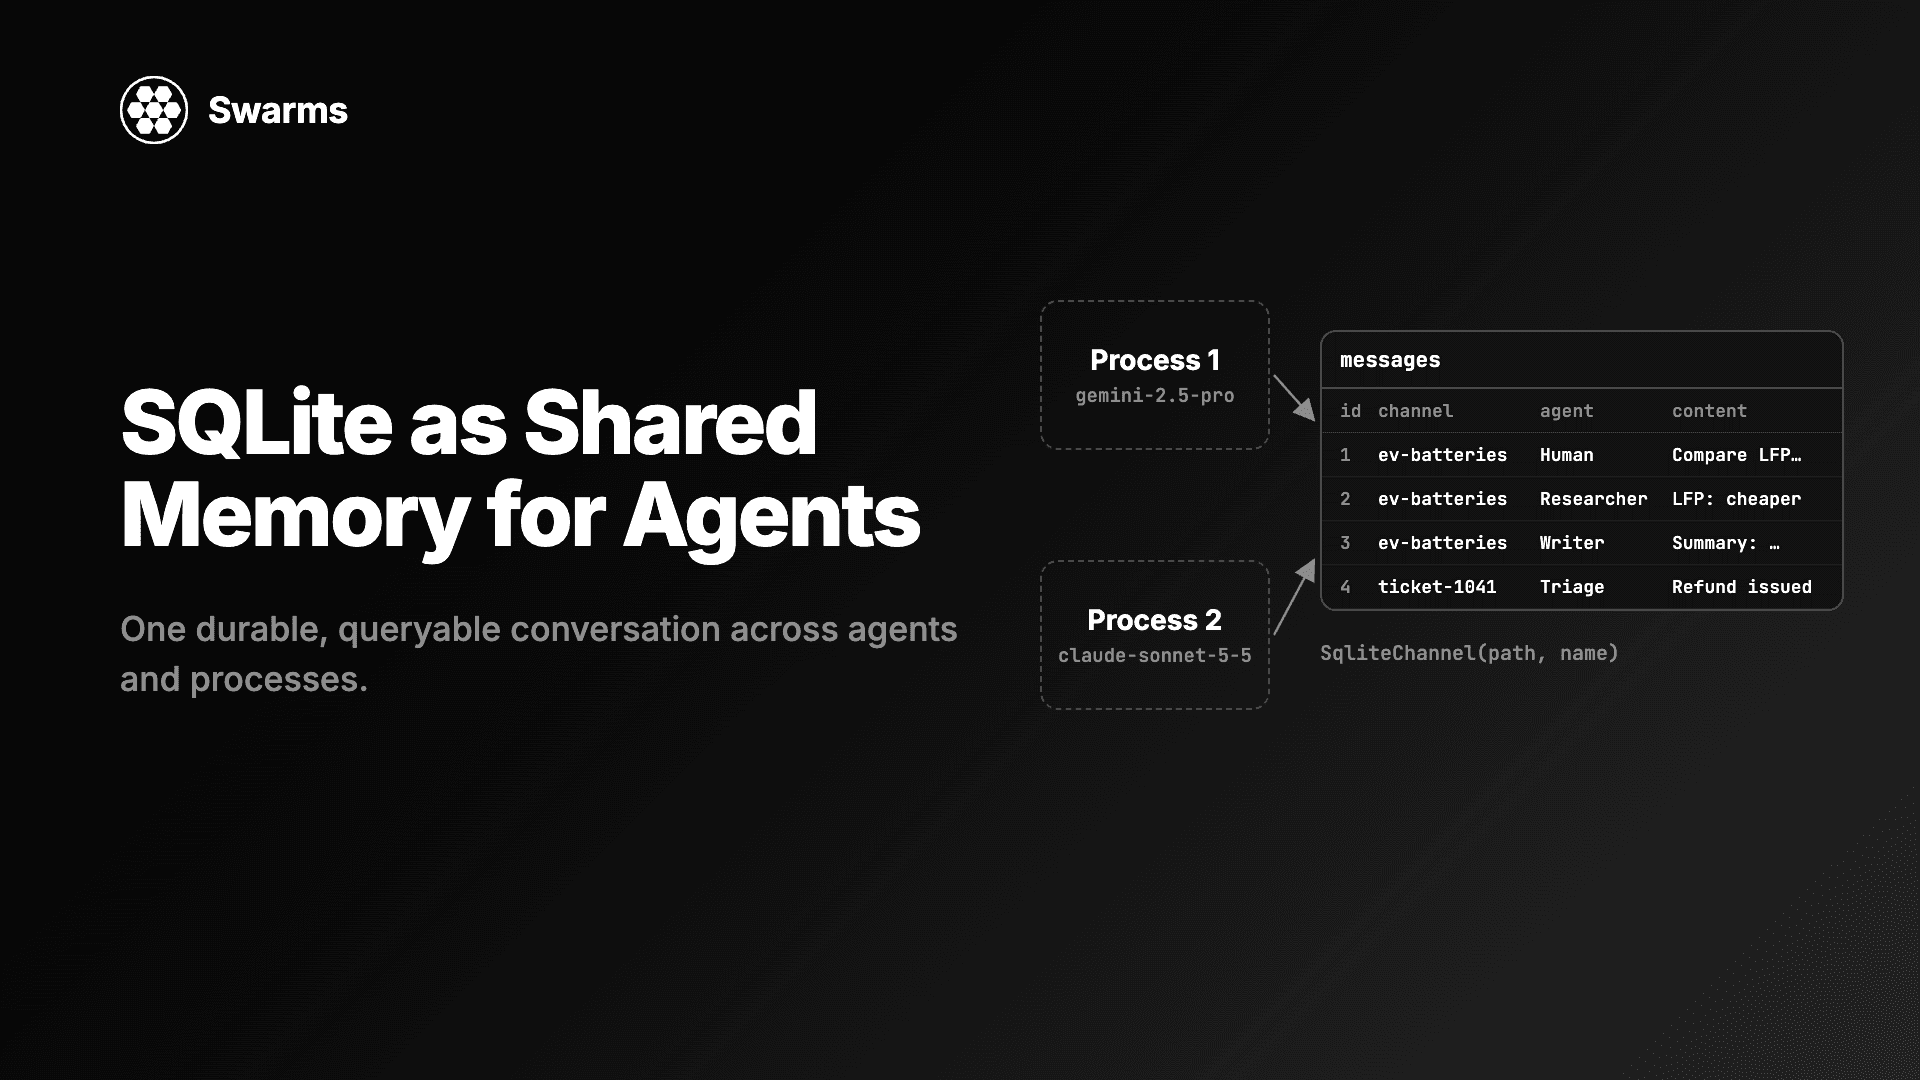
用 SQLite 实现 AI 智能体的共享记忆:SqliteChannel 让多个智能体和进程共用一份持久、可查询的对话历史。用 Swarms 存储、共享这份记忆,并对它运行 SQL。
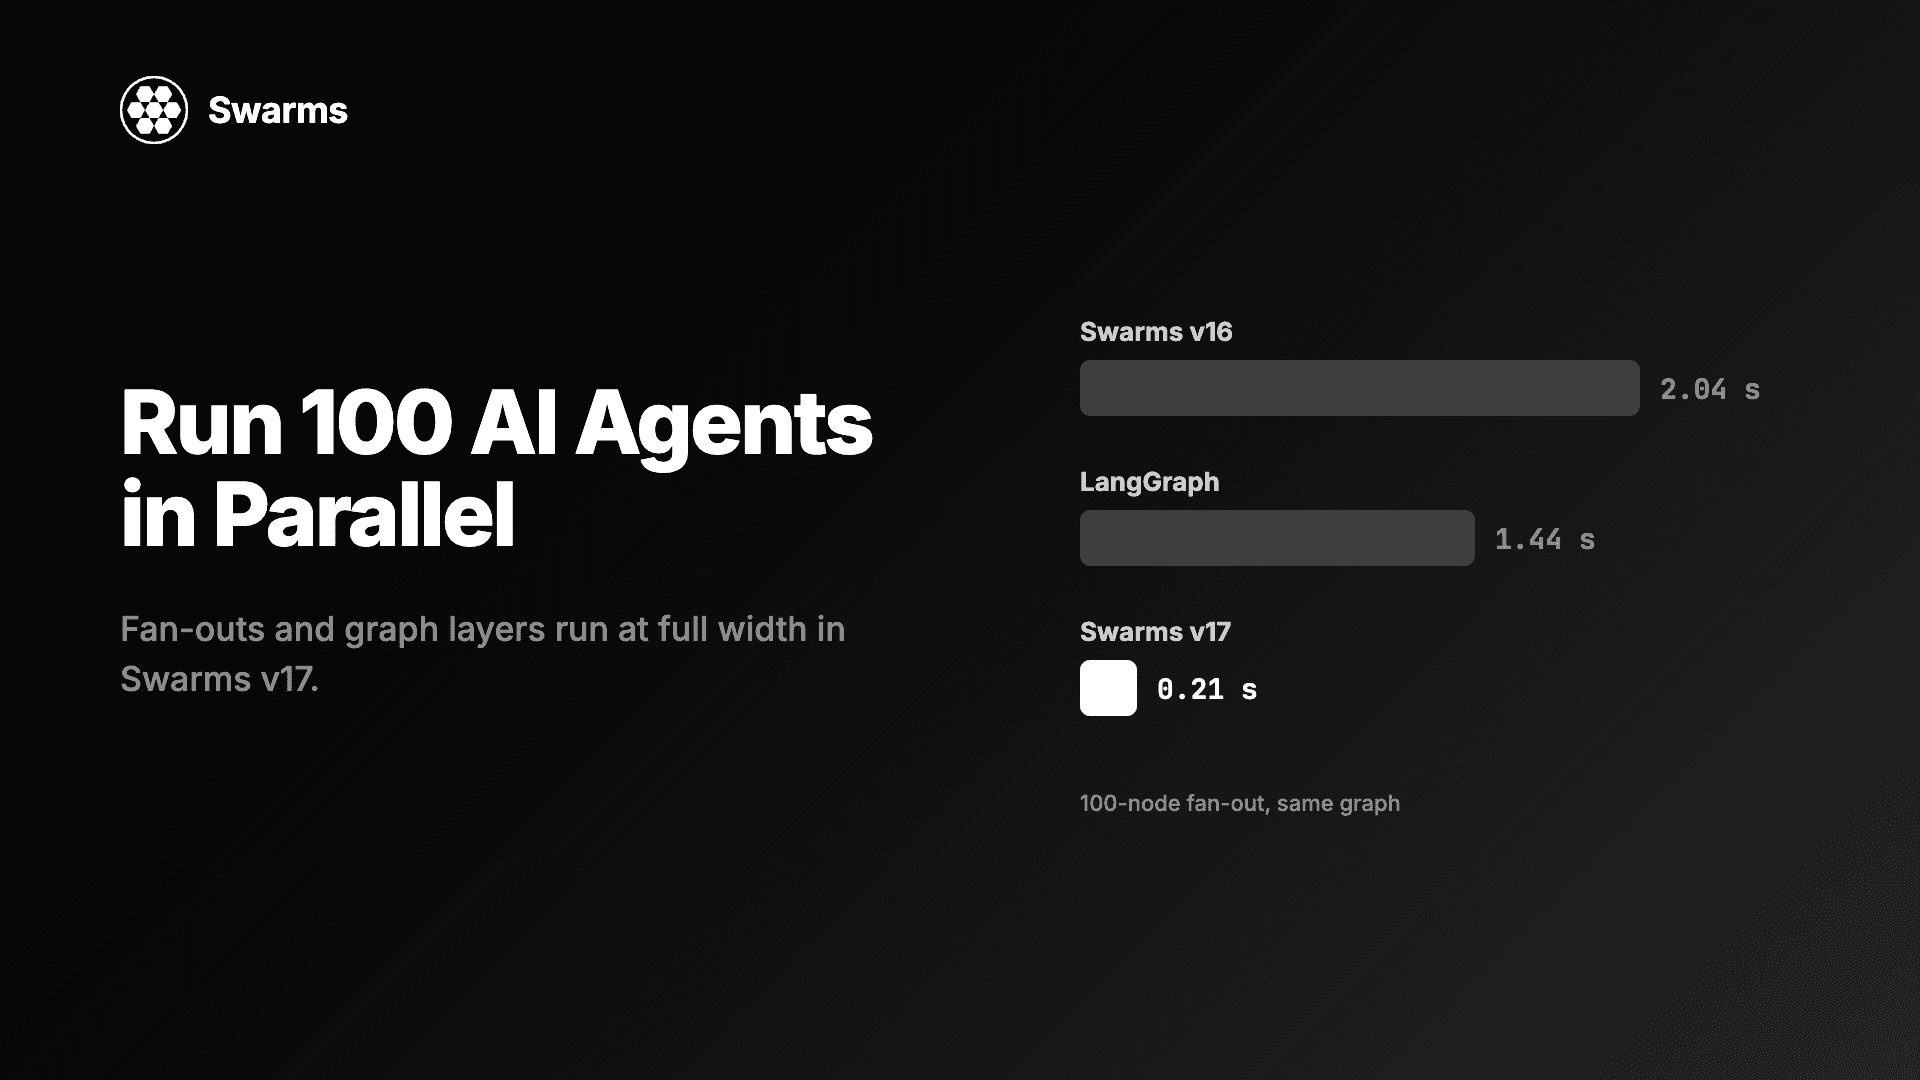
在 Python 中并行运行 AI 智能体:Swarms v17 中 100 个智能体的扇出只需 0.21 秒,此前为 2.04 秒(LangGraph:1.44 秒)。附满宽并发与异步上限的代码。