指南工程
如何观察多智能体系统的思考过程:可以打开和编辑的实时对话记录
用实时对话记录调试多智能体系统:FileChannel 在每条智能体消息产生时就把它写进 Markdown 文件。实时观察智能体协作,在两次运行之间编辑记录,更快定位问题。
Kye Gomez12 分钟阅读

用实时对话记录调试多智能体系统:FileChannel 在每条智能体消息产生时就把它写进 Markdown 文件。实时观察智能体协作,在两次运行之间编辑记录,更快定位问题。
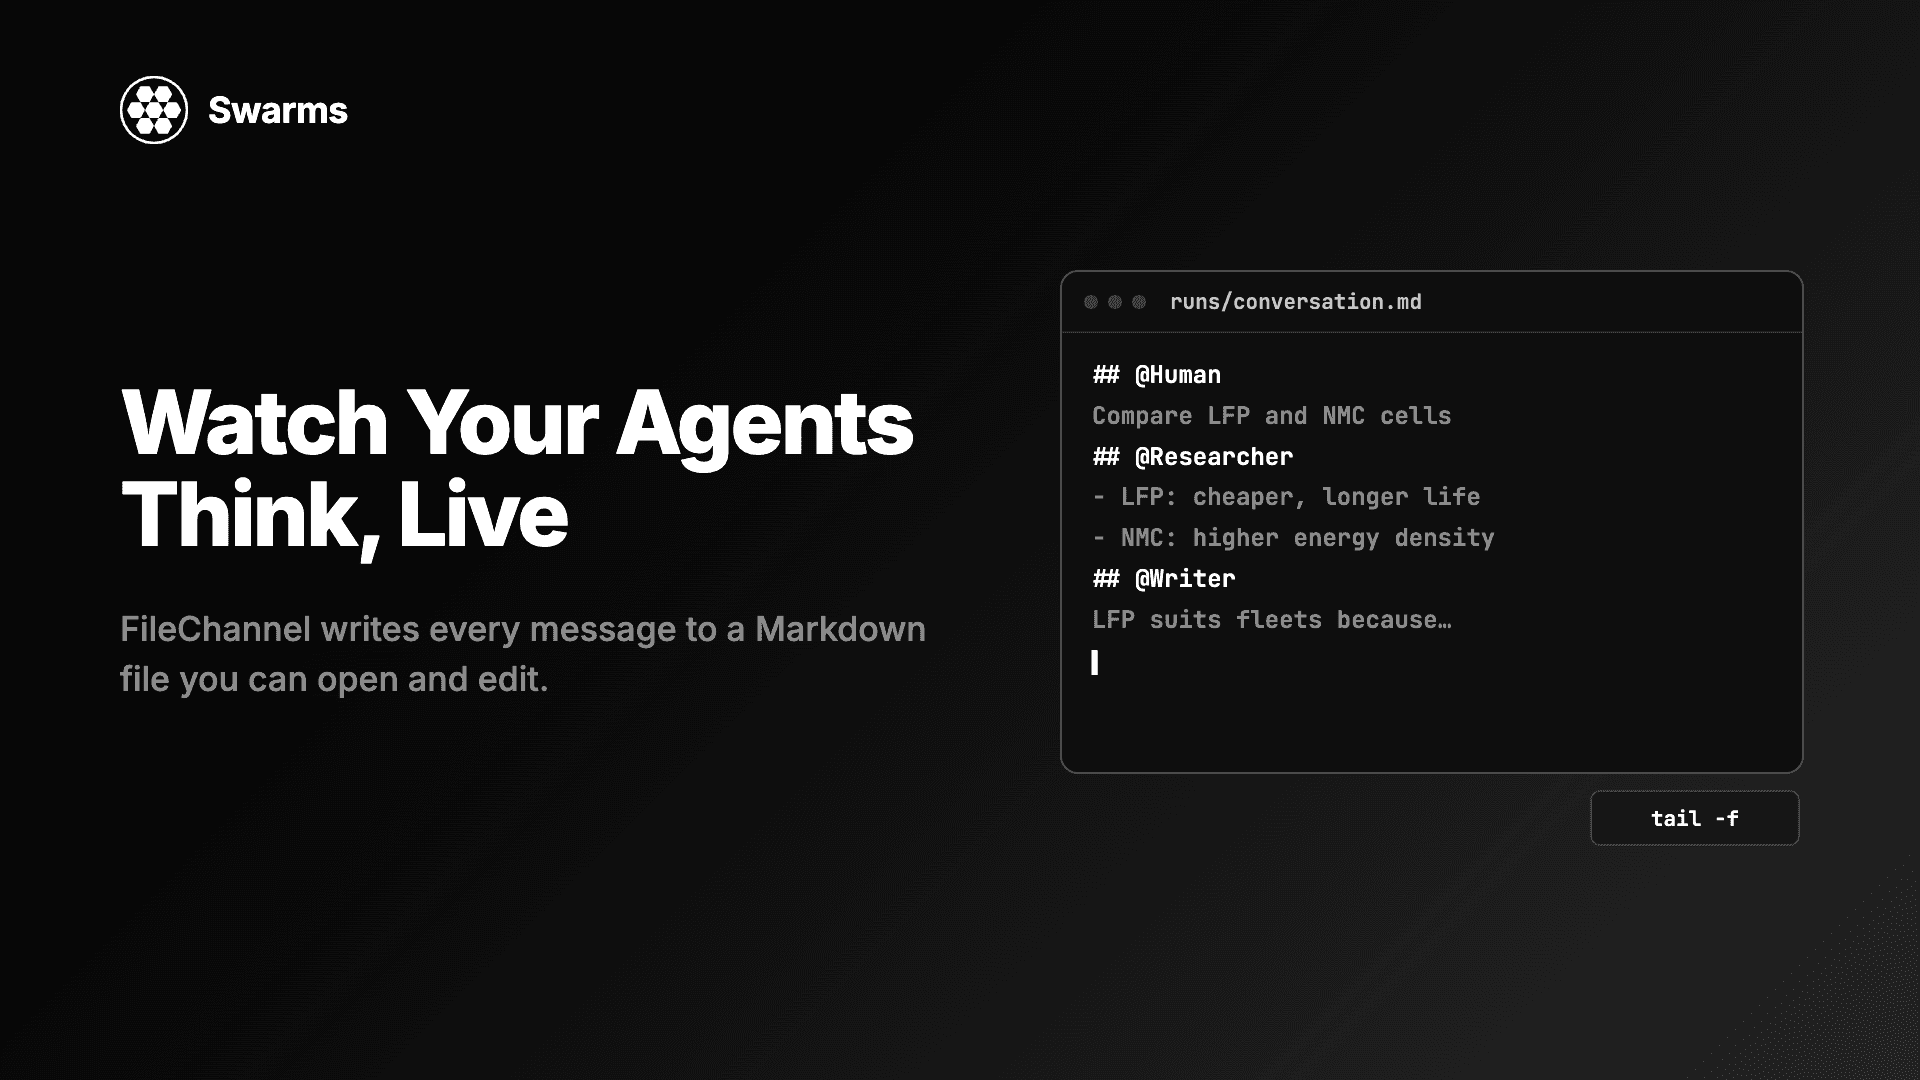
当一条多智能体流水线给出糟糕的答案时,第一个问题是哪个智能体出了错,而大多数架构都让这个问题很难回答。要调试多智能体系统,你需要对话本身:每个智能体收到了什么、说了什么、按什么顺序。本指南演示如何借助 Swarms v17「InterLink」 中的 FileChannel,把这些内容保存为一个普通的 Markdown 文件。每条智能体消息在发布时就会追加到文件里,所以你可以在运行期间 tail -f 它,事后阅读它,还可以编辑它来引导下一次运行。本文还会介绍失败的运行会留下什么、如何流式查看自主智能体的工具调用,以及遥测记录了哪些内容。
下面每个 Python 代码块都是完整的程序,发布前都针对 Swarms 17.0.0 实际运行过。
单个智能体只有一个提示词和一个回答。由四个智能体组成的流水线有四个提示词,而且它们是由彼此的回答拼出来的,你在最后看到的失败,原因往往在更早的地方:
output_type 下,Agent.run 返回智能体的整段对话,而各个结构返回的是各自的格式。两者都给不了你一份按顺序记录谁说了什么的完整记录。一份对话记录能解决大部分问题。如果每条消息都按顺序、以说话智能体的名字落在同一个文件里,你就可以像读聊天记录一样读这次运行,找到第一条出错的消息,从那里开始修正对话,而不必把所有步骤重跑一遍。我们关于多智能体系统失效模式的指南介绍了那些返回看似合理的输出、而不是报错的失效;对话记录正是你发现它们的方法。
FileChannel 是 Swarms 17 中六种通信频道之一。它接受一个以 .md 或 .txt 结尾的路径(其他扩展名会抛出 ValueError),在第一次发布时创建文件,并把每条消息追加为一个 ## @name 标题加上正文:
## @User

Checkout latency jumped from 200 ms to 4 s at 14:05 UTC. ...

## @Investigator

1. The cache TTL change at 14:00 ...

## @Writer

# Postmortem: checkout latency on November 3

...
说话者是那一行 ## @ 之后的全部内容,所以带空格的名字也可以。一条消息的正文一直延续到下一个 ## @ 行,因此回答里的普通 Markdown,包括 # Postmortem 这样的标题,都会原样保留。messages() 每次调用都会从磁盘重新解析文件,没有任何缓存,所以文件就是对话本身。
如果你还没用过频道,配套指南如何在 Python 中让 AI 智能体彼此对话讲解了完整的接口和另外五种频道。
安装 Swarms,并为你用到的每家提供商设置 key(OPENAI_API_KEY、ANTHROPIC_API_KEY、GEMINI_API_KEY、DEEPSEEK_API_KEY、MISTRAL_API_KEY、GROQ_API_KEY):
pip install -U swarms这条流水线负责调查一次事故。Investigator 运行在 gpt-5.4 上;Skeptic 运行在 Gemini 2.5 Pro 上,让质疑来自另一个模型家族;Writer 运行在 Claude Haiku 5.5 上,因为把一段已经结束的讨论整理成一页文档,是一项便宜又快的工作。
from swarms import Agent, FileChannel, SequentialWorkflow

investigator = Agent(
    agent_name="Investigator",
    system_prompt=(
        "You read incident notes and list the most likely root causes, "
        "with the evidence for each."
    ),
    model_name="gpt-5.4",
    max_loops=1,
    print_on=False,
)
skeptic = Agent(
    agent_name="Skeptic",
    system_prompt=(
        "You challenge the root causes in the conversation. For each one, say "
        "what evidence is missing or what else could explain it."
    ),
    model_name="gemini/gemini-2.5-pro",
    max_loops=1,
    print_on=False,
)
writer = Agent(
    agent_name="Writer",
    system_prompt="You write a one-page postmortem from the conversation.",
    model_name="anthropic/claude-haiku-5-5",
    max_loops=1,
    print_on=False,
)

channel = FileChannel("runs/postmortem.md")
channel.clear()  # fresh transcript for this run

workflow = SequentialWorkflow(
    agents=[investigator, skeptic, writer],
    max_loops=1,
    channel=channel,
)
workflow.run(
    "Checkout latency jumped from 200 ms to 4 s at 14:05 UTC. A cache TTL "
    "change shipped at 14:00 and a DNS provider reported issues at 14:10."
)
print(f"Transcript: {channel.path} ({len(channel.messages())} messages)")
它会打印 Transcript: runs/postmortem.md (4 messages):以 User 名义发布的任务,然后每个智能体一条消息。channel.clear() 会先删除文件。去掉这一行,这次运行就会接着上一份记录继续写,这在本指南后面很有用,但如果你并非有意,就会让人困惑。
把频道交给结构即可,它的智能体不需要各自带频道。在 17.0.0 中,SequentialWorkflow、AgentRearrange、ConcurrentWorkflow、GraphWorkflow、MixtureOfAgents、GroupChat、HierarchicalSwarm、PlannerWorkerSwarm 和 MajorityVoting 都接受 channel=,SwarmRouter 则会把它转交给自己构建的 swarm。如果某个成员智能体也带着频道,结构会摘掉它并给出警告,这样每条消息只写一次。
在开始运行之前,打开第二个终端:
tail -f runs/postmortem.md每个智能体一完成,它的回答就会出现在自己的标题下。在顺序流水线里,你会看到对话一轮一轮地增长,某个标题出现前的长时间停顿会告诉你哪个智能体慢。任何能自动重新加载已修改文件的编辑器也都可以。消息在发布时是整条写入的,所以文件里显示的是已完成的轮次;如果要逐 token 的输出,请使用流式输出(见下文)。
tail -f 要求文件已经存在。如果脚本里有 channel.clear(),就先启动运行,或者用 touch runs/postmortem.md 创建一个空文件,然后使用 tail -F,它在文件被删除并重新创建后仍会继续跟踪这个路径。
FileChannel 是一个普通的类,所以你可以扩展它。下面这个子类还会打印每条消息到达的时间和长度,可以快速找出哪个智能体慢,或者哪个写得比别人多三倍:
import time

from swarms import Agent, ConcurrentWorkflow, FileChannel


class TimedFileChannel(FileChannel):
    """A FileChannel that also prints when each message lands and how long it is."""

    def __init__(self, path: str):
        super().__init__(path)
        self.started = time.perf_counter()

    def post(self, agent_name: str, content: str) -> None:
        super().post(agent_name, content)
        elapsed = time.perf_counter() - self.started
        print(f"[{elapsed:6.2f}s] {agent_name}: {len(str(content))} chars")


def make_agent(name: str, model: str) -> Agent:
    return Agent(
        agent_name=name,
        system_prompt="Review the pull request description for problems in your area.",
        model_name=model,
        max_loops=1,
        print_on=False,
    )


channel = TimedFileChannel("runs/review.md")
channel.clear()

ConcurrentWorkflow(
    agents=[
        make_agent("Security", "anthropic/claude-sonnet-5-5"),
        make_agent("Performance", "deepseek/deepseek-v4-pro"),
        make_agent("Style", "groq/openai/gpt-oss-120b"),
    ],
    channel=channel,
).run("PR #482: cache user sessions in Redis and drop the Postgres lookup.")
它会为任务打印一行,再为每个审阅者各打印一行,每行包含从创建频道起经过的秒数和消息长度。Security 用的是更强的 Claude Sonnet 5.5;另外两项审阅范围更窄,用的是更便宜、更快的模型。
读这些时间时要记住一个细节:ConcurrentWorkflow 按智能体顺序发布回答,所以文件里永远是 Security、Performance、Style 的顺序。第一条回答在 Security 完成后立即发布,之后的每一条要等到该智能体以及它前面的所有智能体都完成才会发布。Style 的时间戳很晚,可能意味着慢的是 Security。在顺序流水线里,每个时间戳就是那个智能体完成的时刻。
同一个文件也是数据。几行 Python 就能得到这次运行的索引:
from swarms import FileChannel

channel = FileChannel("runs/postmortem.md")

for i, message in enumerate(channel.messages()):
    preview = message["content"].replace("\n", " ")[:60]
    print(f"{i:>2}  {message['agent_name']:<13} {len(message['content']):>6} chars  {preview}")
每条消息一行,包含说话者、长度和开头几个词。扫一眼这个列表,往往就足以看出运行在哪里跑偏了:一个短得离谱的回答,一个答非所问的说话者,或者一个重复了上一步的步骤。
这是文件形式的对话记录最有用的地方。拿到非空频道的结构会用它初始化自己的对话,所以下一次运行读到的是文件当前的内容,包括你的修改。
假设 Skeptic 的回答是错的。在编辑器里打开 runs/postmortem.md,把 ## @Skeptic 下面的正文替换成它本该说的话,然后保存:
## @Skeptic

The DNS incident started at 14:10, five minutes after latency rose, so it cannot be the trigger.
你也可以从代码里加入一轮自己的发言。然后只运行你想重做的那一步,使用同一个文件:
from swarms import Agent, FileChannel, SequentialWorkflow

channel = FileChannel("runs/postmortem.md")
channel.post(
    "Human",
    "The cache TTL change is confirmed as the cause. Drop the DNS theory and "
    "rewrite the summary around the TTL change.",
)

writer = Agent(
    agent_name="Writer",
    system_prompt="You write a one-page postmortem from the conversation.",
    model_name="anthropic/claude-sonnet-5-5",
    max_loops=1,
    print_on=False,
)
SequentialWorkflow(agents=[writer], max_loops=1, channel=channel).run(
    "Rewrite the postmortem with the correction above."
)

print(channel.messages()[-1]["content"])
我们在手动编辑了 Skeptic 的消息之后运行这段代码时,Writer 的模型收到的是:原始任务、Investigator 的回答、编辑后的 Skeptic 文本、它自己之前的草稿(作为 assistant 轮次)、Human 的更正,以及新任务。只有 Writer 重新运行了;Investigator 和 Skeptic 第二次没有产生任何花费。现在文件末尾是这条更正、以 User 名义发布的新任务,以及新的 ## @Writer 消息。
有几条规则能让编辑保持安全:
## @name 行单独占一行。正文中以 ## @ 开头的一行,在文件读回时会变成一条新消息。agent_name 发布的行,会作为它自己的 assistant 轮次回到它那里。智能体只在运行成功后才发布回答。模型调用失败会抛出异常,频道保留失败之前已经发布的内容。要亲眼看到这一点,给智能体一个提供商会拒绝的模型名:
from swarms import Agent, AgentLLMError, FileChannel

channel = FileChannel("runs/failure.md")
channel.clear()

agent = Agent(
    agent_name="Summarizer",
    model_name="openai/gpt-does-not-exist",  # a model the provider will reject
    max_loops=1,
    output_type="final",
    print_on=False,
    channel=channel,
)

try:
    agent.run("Summarize yesterday's error logs.")
except AgentLLMError as error:
    print(f"Run failed: {str(error).splitlines()[0][:90]}")

print([m["agent_name"] for m in channel.messages()])  # the task, and no answer
这次运行会抛出 AgentLLMError,它会写明智能体和模型,并链接到提供商的原始错误;Swarms 在抛出之前还会把 traceback 记入日志。对话记录里是 ['Human']:任务已经发布,但没有任何半成品或错误文本被当作回答写入。
各个结构遵循各自的失败策略:
SequentialWorkflow 会抛出异常。当三个智能体中的第二个失败时,文件以任务和第一个智能体的回答结尾,所以最后一个标题告诉你运行走到了哪一步。ConcurrentWorkflow 默认是 on_error="store":其他智能体继续完成,失败的那个以 ## @Name (failed) 标题记录,正文是 Error: ...。扇出运行结束后,在文件里搜索 (failed)。传入 on_error="raise" 则会在第一次失败时中止运行。因为任务已经在文件里,在同一个频道上重试不会把它发布两次。fallback_models 列出按顺序尝试的模型,主模型排在第一位:
from swarms import Agent, FileChannel

channel = FileChannel("runs/failure.md")

agent = Agent(
    agent_name="Summarizer",
    # The first model is the primary; the rest are tried in order when it fails.
    fallback_models=["openai/gpt-does-not-exist", "gpt-5.4-mini"],
    max_loops=1,
    output_type="final",
    print_on=False,
    channel=channel,
)
agent.run("Summarize yesterday's error logs.")

print([m["agent_name"] for m in channel.messages()])
它会打印 ['Human', 'Summarizer']。主模型失败,gpt-5.4-mini 给出回答,只有这条回答以智能体的名字发布。对话记录不会记下回答来自哪个模型,所以如果这一点对调试很重要,请查看 Swarms 回退时记录的警告,或者查看遥测。
对话记录记录的是智能体之间的轮次。而在单个自主智能体(max_loops="auto")内部,大部分工作都是工具调用:create_plan、你的工具、subtask_done、complete_task。在 v17 之前,流式输出只转发文本内容,所以流式消费者几乎看不到自主运行的任何过程。在 v17 中,输出流包含模型产生的一切:文本原样输出,推理内容带 [thinking] 标题,每个工具调用带 [tool call] <name> 标题,后面跟着它的参数。
两者一起用:输出流用来看单个智能体的内部,频道用来留存记录。
from swarms import Agent, FileChannel


def get_weather(city: str) -> str:
    """Get the current weather for a city.

    Args:
        city: Name of the city.

    Returns:
        A short weather report.
    """
    return {"Paris": "18C and sunny", "London": "12C and raining"}.get(city, "15C and cloudy")


channel = FileChannel("runs/weather.md")
channel.clear()

agent = Agent(
    agent_name="Weather-Agent",
    model_name="gpt-5.4-mini",
    max_loops="auto",
    tools=[get_weather],
    print_on=False,
    channel=channel,
)

for token in agent.run_stream("Get the weather in Paris and London, then tell me which is warmer."):
    print(token, end="", flush=True)

print("\n\nPosted to the channel:")
print(channel.messages()[-1]["content"])
输出流会在每一步发生时显示它,形式如下:
[tool call] create_plan {"task_description": "...", "steps": [...]}
[tool call] get_weather {"city": "Paris"}
[tool call] subtask_done {"task_id": "fetch_paris", "summary": "...", "success": true}
[tool call] get_weather {"city": "London"}
...
[tool call] complete_task {"task_id": "main_task", "summary": "...", "results": "..."}
频道在 ## @Weather-Agent 下只得到一条消息:最终回答,对于自主运行来说就是 complete_task 的结果(以 complete_task result: Task Completion Summary 开头,包含结果和每个子任务的摘要)。工具调用不会进入对话记录,所以即使智能体运行几十步,记录依然清晰可读。run_stream 在后台线程中运行智能体,并在输出流结束后重新抛出任何错误。arun_stream 是它的异步版本,streaming_callback 也会收到同样的内容。
调试时,v17 有两处变化值得注意。
遥测默认开启,而且记录得很多。每次被追踪的调用都会记录它的参数以及发起调用的结构的完整对话,每次 Agent.run 都会记录它使用的 token,每次模型调用都有自己的 span,包含延迟、模型、结束原因、确切的请求以及提供商的完整响应。名称指向凭据的字典键会被替换为 <redacted>;消息文本不会被清洗,所以粘贴进提示词的密钥会原样发送。导出数据发往 https://telemetry.swarms.world,所以应把它看作 Swarms 那一侧对你的运行的视图;你自己的调试记录是对话记录。要关闭它:
export SWARMS_TELEMETRY_ON=False在 v17 中,关闭就是彻底关闭:不会导入任何 OpenTelemetry 模块。这个开关在导入 swarms 时读取,包括从 .env 文件中读取,所以要在导入之前设置。
除非你要求,Swarms 不会写日志文件。 调试时想要日志文件:
export SWARMS_LOG_FILES=True日志文件会写到 WORKSPACE_DIR/logs 下(未设置 WORKSPACE_DIR 时是 agent_workspace/logs)。
runs/2026-11-04-postmortem.md,这样新的运行不会意外接着旧的写下去。SqliteChannel,它在线程和进程之间都是安全的。智能体代码不需要改动。先把智能体之间交换的每条消息都记录下来。给你的结构一个 FileChannel("runs/run.md"),按顺序阅读文件,找到第一条出错的消息。然后修正这条消息或者加一条更正,在同一个文件上只重跑它之后的步骤。
把 FileChannel 传给智能体或结构,在另一个终端里对文件运行 tail -f。每个回答一经智能体发布,就会出现在 ## @agent_name 标题下。如果想在代码里而不是文件里拿到每条消息,就用 QueueChannel,在消费者线程里遍历它。
可以。编辑文件,然后让一个只包含剩余智能体的新结构指向同一个 FileChannel。它会用磁盘上文件的当前内容初始化对话,所以后面的智能体看到的是你编辑后的文本。
失败的 Agent 运行什么都不发布:它抛出 AgentLLMError,文件保留失败之前的消息,所以在 SequentialWorkflow 中,最后一个标题显示运行走到了哪一步。使用 fallback_models 时,只有成功的回答会被发布。ConcurrentWorkflow 默认是个例外:它会把失败的智能体记录为 Name (failed) 并附上错误文本,同时让其他智能体继续完成。
每次发布向本地文件追加一条消息,每次读取把文件解析一遍。和一次模型调用相比,这点开销很小;当单个文件变得难以处理时,SqliteChannel 保持相同的接口,并提供带索引的存储。
pip install -U swarms给你正在调试的结构加上 channel=FileChannel("runs/debug.md"),开着 tail -f 运行它,在修改任何提示词之前先读一遍文件。Swarms v17 更新日志列出了随通信频道、自主运行流式输出和遥测一起发布的全部内容,如何在 Python 中让 AI 智能体彼此对话介绍了其他频道。文档在 docs.swarms.world,源代码在 GitHub。
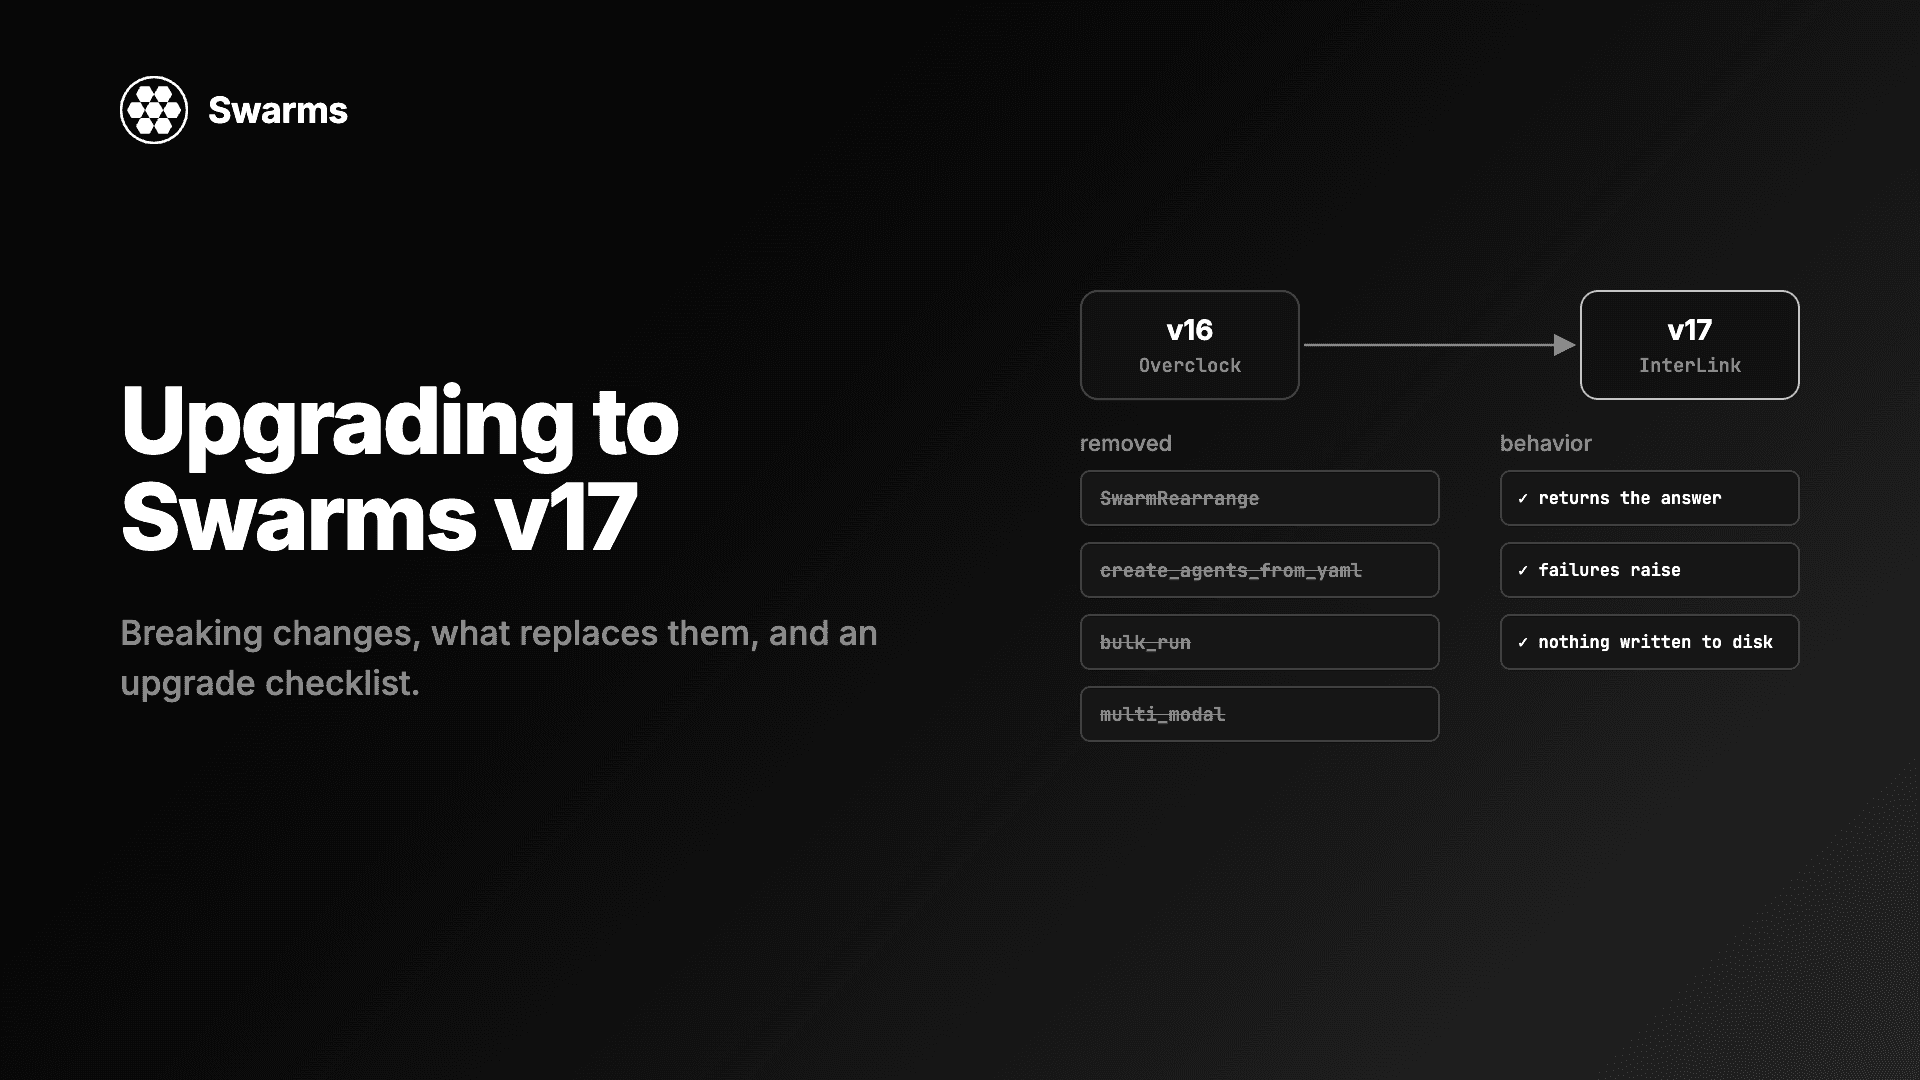
Swarms v17 升级与迁移指南:InterLink 中移除的每个类和参数、应该改用什么、变更的默认行为,以及一份升级检查清单。
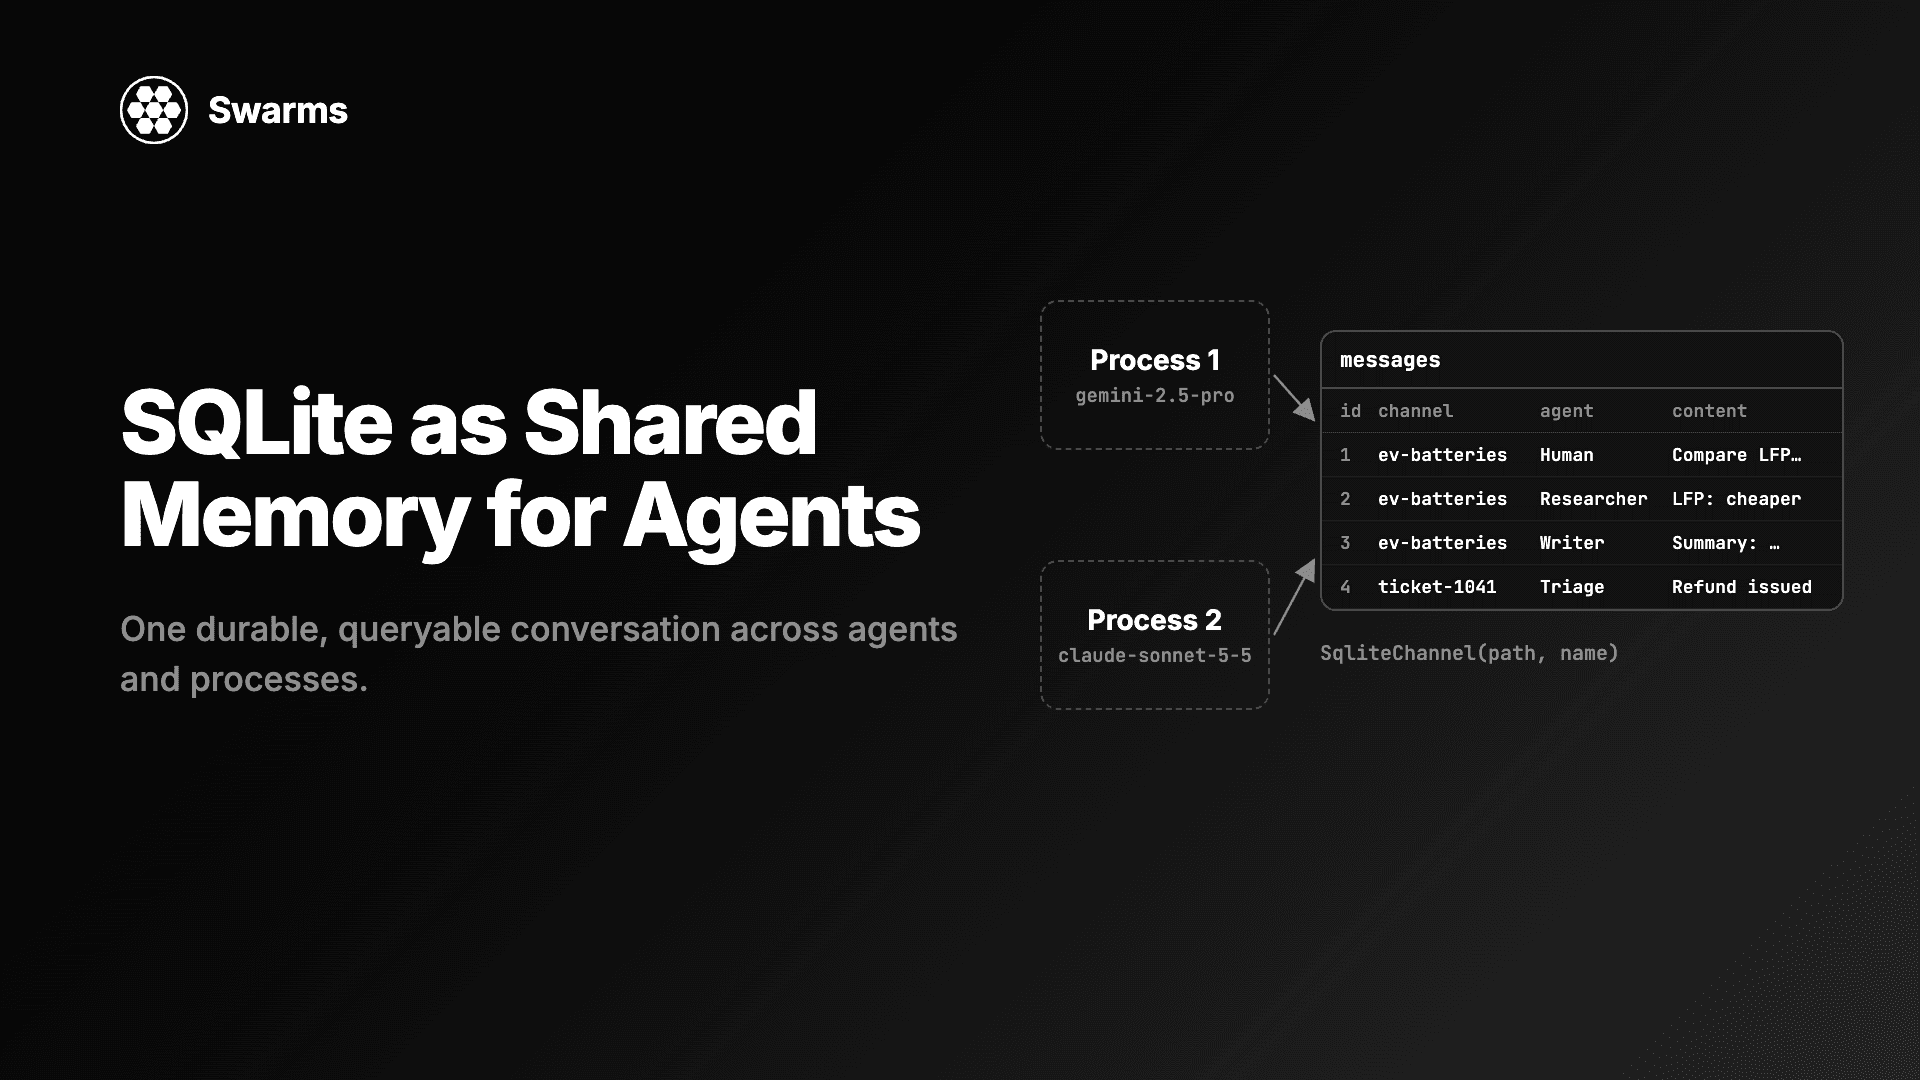
用 SQLite 实现 AI 智能体的共享记忆:SqliteChannel 让多个智能体和进程共用一份持久、可查询的对话历史。用 Swarms 存储、共享这份记忆,并对它运行 SQL。
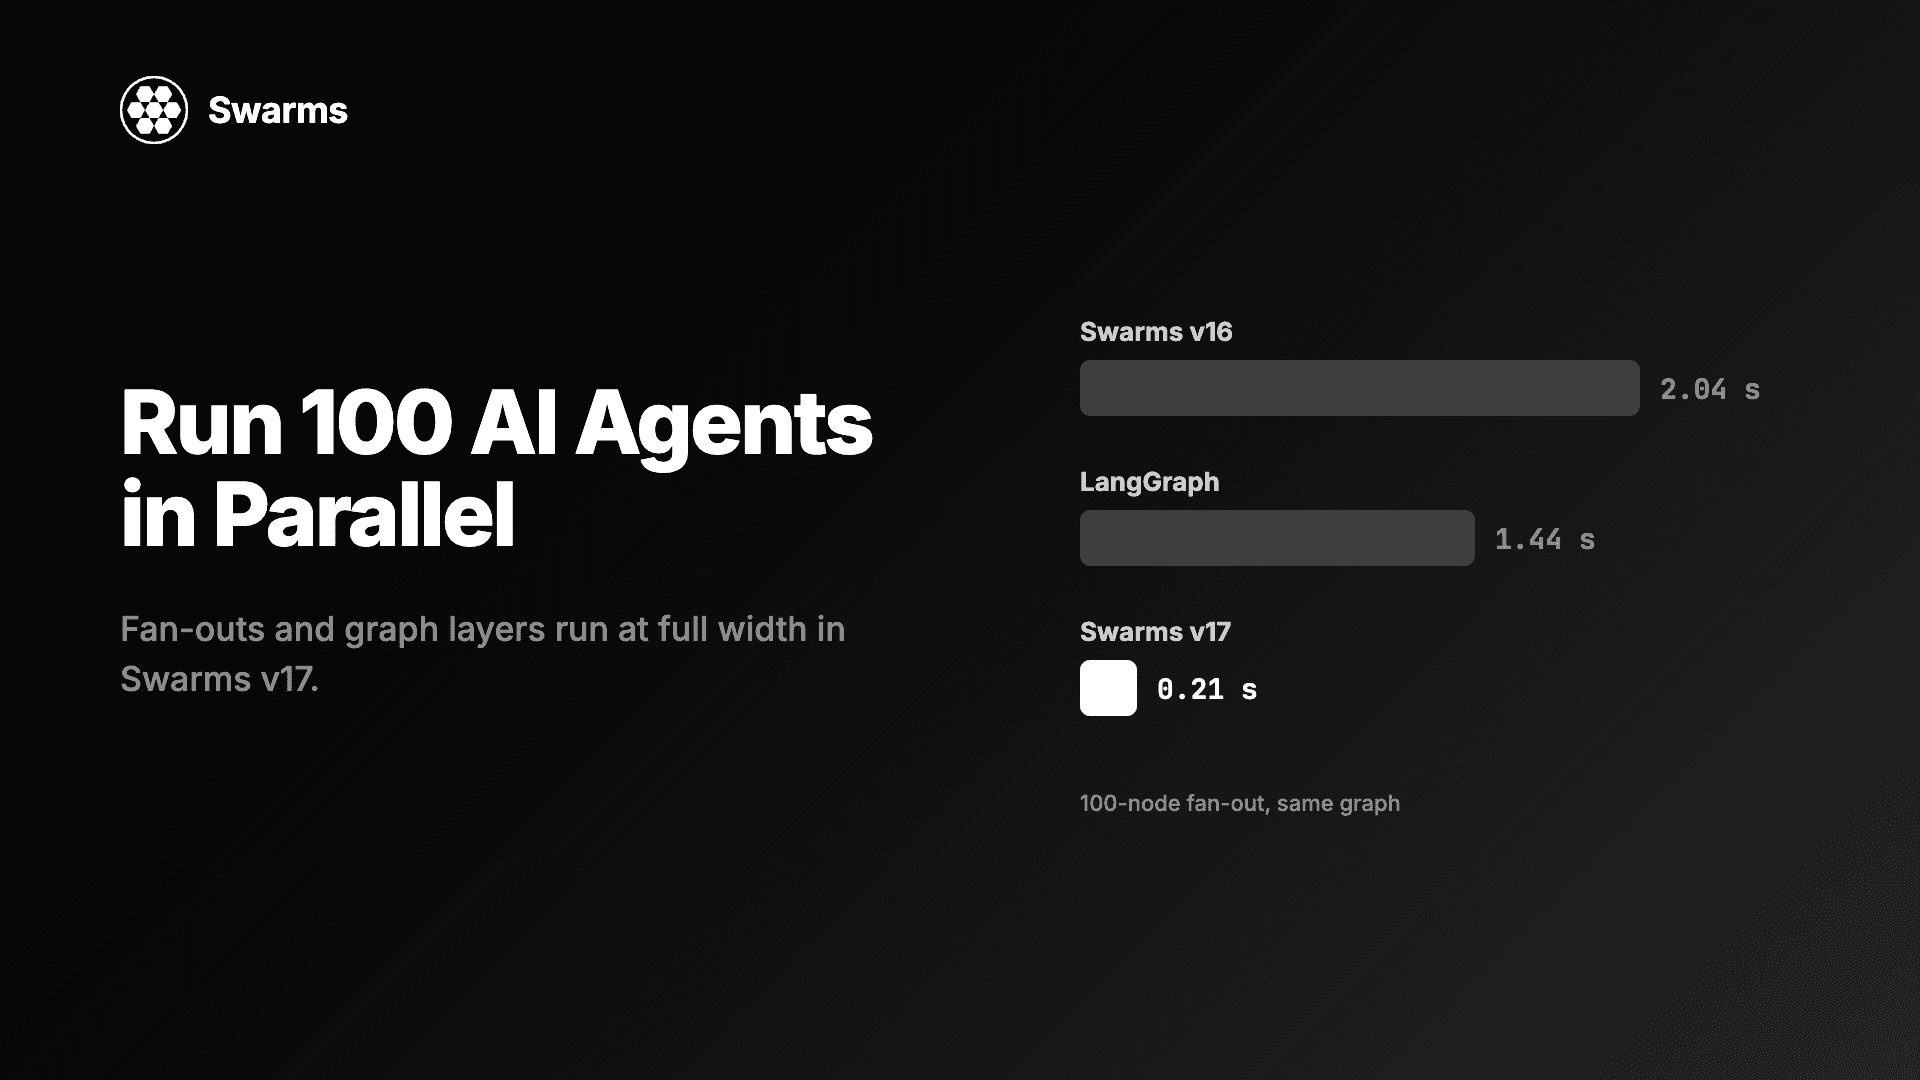
在 Python 中并行运行 AI 智能体:Swarms v17 中 100 个智能体的扇出只需 0.21 秒,此前为 2.04 秒(LangGraph:1.44 秒)。附满宽并发与异步上限的代码。